



修复 Plus 耗尽后,有额度的 Pro 手机锚仍被自动选号排除的问题。「手机锚最后使用」开启时,所有其他符合现有自动切入规则的可用账号优先,只有它们全部不可用时才自动使用手机锚;此优先级高于套餐评分和满额 Plus 加分,其他账号的可用积分也先使用。额度耗尽、封禁、退出登录等健康检查仍适用于手机锚。自动会话绑定使用相同的兜底规则,手工选择与明确指定路由不受此优先级限制。
沿用原有设置字段并保留默认开启,不需要重新设置手机锚。此修复只调整代理请求的自动选号;磁盘上的手机锚登录身份及手机连接保护继续保留。
此前 Client 只能将 Skills 上传到 Server,无法自动拉取;直接复制 Mac Skills 到 Linux 时,写死的用户目录和 macOS 命令也可能导致无法使用。现在新增通用的 Server → Client 自动同步,复用已配置的 Server 地址、回退地址和共享密钥,不绑定特定用户名或机器。
- 在 Client 设置中开启「自动拉取 Server Skills」,启动时及每 5 分钟拉取,也可点击「立即拉取 Skills」。默认关闭;Server 与 Client 均需更新到支持此功能的版本。
- Skills 存放于当前用户的
~/.codex-switcher/skills。副本中的 Server Home 引用按 Client Home 适配;Linux 按本机 PATH 解析 Homebrew 可执行文件路径,并过滤 macOS 专用内容和缺少本机依赖的 Skills。 - 支持
compatibility.json声明平台与所需命令。保留本机.system、自有 Skills 和本机修改;更新或移除受管理副本时先归档,连接失败时保留上次内容。 - 同步副本不再通过「同步到 Server」反向上传,避免把 Linux 路径覆盖回 Mac 原文件;拉取结果同步更新 Skills 列表。
验证:Mac/Linux 构建通过,7 项同步测试与 6 项国际化测试通过;实机验证自动定时更新、不同用户 Home 适配、本机内容保留、远端移除归档及 Codex CLI 读取。具体配置见下方「多机器共享账号池」。
v0.7.19 新增:阶跃星辰 StepFun Step Plan 支持。
在「添加中转 → CODING PLAN → 阶跃星辰 Step Plan」中填入 Step API Key,即可接入
https://api.stepfun.com/step_plan/v1。Switcher 会直接读取官方/models返回的原生step-*模型,模型列表中可直接选择,不需要 GPT 别名映射。Step Plan 的额度查询可选填
platform.stepfun.com的Oasis-Token;它只用于读取订阅 Credit / 加油包额度,不参与模型请求。Step Plan 使用 Chat Completions 协议,Switcher 会自动转换 Codex Responses 请求。
Luna Reserve 备用额度现已支持。 当账号的常规高级模型额度暂时耗尽时,Switcher 会识别该账号可用的 Luna Reserve,并让
gpt-5.6-luna继续使用这部分独立额度,避免因误判常规额度耗尽而提前切换账号。
Luna Reserve 是 OpenAI 在常规高级模型额度耗尽后,为部分账号提供的独立临时额度。它只适用于 gpt-5.6-luna,与普通 5 小时额度、周额度分别计算;因此普通 5H 显示为 0% 时,Luna Reserve 仍可能保持可用。

Switcher 会从用量接口读取这项独立额度,并在账号列表中单独展示剩余比例和重置时间:

当 Luna Reserve 仍可用时,使用 gpt-5.6-luna 不会因为普通额度耗尽而自动切换账号;Reserve 耗尽、过期或明确不可用后,系统才恢复正常的切号策略。
- 修复 Responses Relay 经过本地 WebSocket → HTTP/SSE bridge 后回落官方账号的问题。
- 当前 Relay 和 hard route 会在 token 解析前固定使用 Relay 自身的 API Key、base URL 和模型映射。
/v1/responses与/v1/responses/compact均保持同一 Relay 路由,不再误走官方账号或远程 Server。
- 修复 native Responses Relay 的
/responses/compact请求被过滤 compaction item 的问题。 - chat-completions Relay 不再伪造普通完成响应来处理 compaction;改为返回可重试的受控错误。
- Responses Relay 的 WebSocket 请求改走本地 HTTP/SSE 适配,兼容不提供原生 WebSocket 的中转。
- 阶跃星辰 StepFun Step Plan:接入 Step Plan Chat Completions,直接读取官方原生模型目录并在 Codex 模型选择器中展示;接入订阅 Credit、加油包和 5H/7D 额度查询。
- 协议兼容修复:修复 Chat Completions Relay 的 zstd 请求体重复解压,以及 function tool 缺少合法
parameters导致 StepFuninput_invalid的问题。
- Credits 余额显示:ChatGPT 账号列表直接显示
/wham/usage返回的credits.balance数字;明确为 0 和尚未查询分别显示,避免把未知状态误判成无余额。 - Credits 余额参与自动切号:普通 5 小时/周额度耗尽后,明确还有正 Credits 余额的账号仍会作为候选,并在切换前重新确认可用性。
- 邀请活动按套餐匹配:Plus/Pro 使用个人邀请活动,Team/Business/Enterprise/Edu 使用工作区邀请活动;入口分别显示“邀请朋友”和“邀请同事”,减少因活动类型不匹配导致的 403。
- 跨客户端缓存兼容:旧版远端缓存缺少新余额字段时,client 模式会保留本机最后一次明确查询结果,不会被旧数据覆盖。
- 修复标题栏版本号写死为旧版本的问题。现在从 Tauri 运行时读取应用版本,发布新版本后 UI 会与安装包版本保持一致。
- 修复 Luna Reserve 实际耗尽后仅关闭 WebSocket、导致 Codex 发送按钮被禁用的问题。
- 上游确认
usage_limit_reached后,系统会标记 Reserve 已耗尽并切换到可用账号,让 Codex 自动重连继续工作。
- 修复 WebSocket 预检阶段忽略
gpt-reserve路由提示的问题。 - 当前账号存在可用 Luna Reserve 时,
gpt-5.6-luna请求不会被普通额度预检提前切到其他账号。
- 新增 Luna Reserve 独立额度识别与展示。
- 当
gpt-5.6-luna的 Luna Reserve 仍可用时,普通 5 小时额度耗尽不会触发自动切号。 - Luna Reserve 不可用、耗尽或过期后,系统恢复原有的安全切号策略。
本版本是在 v0.7.10 基础上的一次集中更新,重点是让额度窗口真正开始滚动、提高 Plus 账号利用率,并补齐 Google/Antigravity、Kimi/DeepSeek Relay、账号邀请和跨客户端 Skills 能力。
- 刷新账号额度后,如果发现新的 5 小时或 7 天窗口需要启动,系统会在防重复记录落盘后,向对应账号发送一次极小的 Codex 请求,让该窗口真正开始计时;同一个窗口事件不会重复发送。
- 当 Plus 和 Pro 账号同时存在时,Plus 的 5 小时窗口回满且周额度仍可用,系统会优先把当前使用切到 Plus,避免 Plus 额度闲置;不会把周额度已经耗尽的 Plus 当作可用账号。
- 周期保鲜按接口返回的实际窗口识别 5H/7D,不把套餐名称硬编码成窗口类型;client/solo 模式由权威端执行,减少多机重复刷新和 refresh token 冲突。
- Google Antigravity:原生 OAuth、模型发现、配额展示、工具调用和 Responses 协议转换更加完整。
- Relay:支持 Kimi Coding Plan 和 DeepSeek 原生模型、5H/周额度展示,以及按模型选择当前账号。
- 账号管理:补充 ChatGPT Desktop 邀请与奖励入口,改善订阅账号状态、Token 刷新和批量额度读取。
- Skills:统一 Codex、Claude、Gemini、OpenCode、Grok、Kimi 与 Antigravity 的本地 Skills 管理和同步。
- 手机锚:设置手机锚后,本机 current 不再被 Mini Mac Server 的后台 current 同步改回,仍可正常切换代理出口账号,同时保持磁盘 auth.json 绑定锚账号。
- Windows 托盘:右键现在使用完整的原生托盘菜单,左键继续打开快捷面板。
- 稳定性:修复 WebSocket 路由、跨账号切换、远程同步、额度接口路径和 Tauri APP 构建/签名流程中的问题。
Codex Switcher 是一个面向 Codex CLI / Codex App 多账号工作流的桌面工具。它把账号管理、配额观察、本地代理、无损自动切号、中转站、Coding Plan 接入、远程账号池和 Skills 管理放在同一个 Tauri 应用里,适合长期使用 Codex CLI、Codex App,以及支持 Codex 插件的 VS Code 及其衍生 IDE 的多账号环境。
一句话:当前账号限额了,前端任务不用停,Codex Switcher 在代理层自动换号、切换中转站或接入 Coding Plan,并自动重发请求。Coding Plan 目前支持 GLM、Xiaomi MiMo Token Plan 和阶跃星辰 StepFun Step Plan。
Important
Codex Desktop 的 Team / Business 登录可以保留。 部分 macOS Codex Desktop 版本存在打开任务后账号设置接口返回 401、随后被全局退出登录的回归,详见 openai/codex#39162。如果个人 Plus / Pro 登录会循环退出,而 Team / Business 工作区可以稳定启动,请让 Desktop 继续登录 Team;菜单里 Team 的 0% 只代表 Desktop 当前工作区,不代表 Codex Switcher 实际选中账号的额度。
本项目在最终 HTTP / WebSocket 出站前会删除 Desktop 带入的旧工作区身份,并按实际选中的账号重新绑定 Authorization 与 chatgpt-account-id。因此 Desktop 可以用 Team 维持壳层登录,代理请求仍使用 Codex Switcher 当前选择的 Plus / Pro / Team / Relay 账号;切号、重试和远程 Server 转发也遵循同一规则。
- Luna Reserve 备用额度:自动识别 OpenAI
gpt-reserve独立额度。普通高级模型额度耗尽后,只要gpt-5.6-luna的 Reserve 仍可用,就继续留在当前账号,不误触发切号;状态、剩余比例和重置时间也会单独展示。 - 手机锚:将 Codex.app 手机远程连接绑定的磁盘身份与代理出口账号分离,手机端保持在线,CLI/IDE 请求仍可切换到其他账号。
- 会话级路由:把单个 Codex 会话固定到 ChatGPT、GLM Coding Plan、MiMo 或其他 Relay,立即生效,无需重启客户端。
- 无损自动切号:统一处理额度耗尽、封禁、401、429、Token 失效、上下文超限和全局容量问题,并在 SSE/WS 错误到达客户端前完成重试。
- Desktop 身份隔离:Codex Desktop 可继续使用 Team / Business 登录,代理请求独立使用当前账号的 Token 与
chatgpt-account-id,减少假 401 和错误切号。 - Credits 余额与邀请管理:账号列表直接显示 ChatGPT Credits 余额,并区分 0 与未查询;邀请入口按 Plus/Pro 或 Team/Business/Enterprise/Edu 选择对应活动。
- 统一账号池:集中管理 ChatGPT OAuth、OpenAI API Key、第三方 Relay、Coding Plan 和远程账号池,并支持按类型、套餐和状态筛选。
- 多协议与模型接入:支持原生 Responses 转发,也支持转换为 Chat Completions,接入 GLM、Xiaomi MiMo、DeepSeek、Kimi、MiniMax、通义、火山、UCloud、OpenRouter 等服务。
- StepFun Step Plan:直接读取官方
step-*模型列表,支持 Step API Key、Step Plan 原生模型选择和控制台 Credit 额度查询。 - 模型级 Relay 路由:同一 Relay 账号池可按模型选择不同当前账号,支持 WebSocket 与流式 Responses 适配。
- 主动额度管理:独立展示 5H/周额度、Spark、Luna Reserve、重置次数和周期状态,并按接口真实窗口识别 5H/7D。
- 稳定的长任务代理:提供 SSE bootstrap、流中错误检测、30 秒 keep-alive、WebSocket 双向桥接、session affinity 与 prompt cache 隔离。
- 可审计运行状态:记录 Token 用量、成本、缓存收益、切号原因、会话绑定和额度周期,便于定位账号、模型或全局容量问题。
- 跨工具 Skills 管理:统一发现、安装和同步 Codex、Claude、Gemini、OpenCode、Grok、Kimi 与 Antigravity Skills。
历史版本能力说明
- 手机锚(v0.7.0 新增):Codex.app 26.513+ 加了"手机远程连接"功能(手机/Codex.app 桌面端通过 ChatGPT 后端 bridge),但 bridge 鉴权绑死
auth.json的chatgpt_account_id,每次切号必断。手机锚把 disk 锁定在指定订阅号 —— 切到非锚账号时磁盘不动 / proxy 出口照切,让 Codex.app 仍以锚账号身份在线,手机端不掉线,而你的 codex CLI 实际跑在切走的那个号上。后台 4 min 独立 tick 保活锚号 token,rt 单写者保持是 Codex Switcher。详见[安装节][#手机锚phone-anchorv070]。 - 会话路由(v0.6.0 新增):UI 一键把 codex 的"当前活跃会话"硬绑到指定账号 —— 这个对话强制走 GLM Coding Plan、那个对话强制走 MiMo、剩下走 ChatGPT。绑完立刻生效,不需要关 codex tab、不需要重启 Codex Switcher;底层用
ws_disconnect踢断长连接、让 codex 自动重连进新路由。 - 无损切号:限额、封禁、401、全局容量不足时,代理层自动换号并重发请求,前端软件无感知。401 / 429 / 上下文超限 / token 失效 / RT 被轮换都已闭环。
- Desktop 工作区与代理账号隔离:Codex Desktop 可以固定登录 Team / Business 保持应用稳定;每个代理请求会把 bearer token 和
chatgpt-account-id作为同一账号的身份对重建,避免“新 token + 旧 Team workspace”造成假 401、假限额和切号风暴。 - 三类账号统一调度:订阅 (ChatGPT OAuth/API Key) · 中转 (PinCC/PackyCode/CLIProxyAPI 等聚合 reseller) · Coding Plan (GLM/MiMo/火山/UCloud 等厂商订阅) · 三方 (DeepSeek/Kimi/MiniMax/通义/Fireworks/OpenRouter 等按量付费)。可分别独立过滤、独立挑号策略。
- 17 个内置 Relay preset:除 GLM 和 MiMo 外,新增 DeepSeek / Moonshot / MiniMax / 通义千问 / 火山方舟 / 腾讯混元 / 百度千帆 / UCloud / Fireworks / Stepfun / OpenRouter + 一个适配所有 new-api/sub2api/CLIProxyAPI 兼容站的通用 Responses 中转。
- GLM Coding Plan 兼容:把 Codex
/v1/responses实时翻译成 OpenAI/chat/completions,让 GLM Coding Plan 也能跑 Codex 请求。 - Xiaomi MiMo Token Plan 兼容:内置 MiMo-V2.5 Token Plan 新加坡端点 preset,支持
tp-key 和 Chat Completions 翻译。MiMo thinking 模式reasoning_content强校验做了历史修剪 workaround。 - DeepSeek 已端到端验证:单轮、多轮 tool_call、
deepseek-reasoner流式 reasoning summary 全部通过;模型映射gpt-* → deepseek-chat / o1 → deepseek-reasoner。 - 上下文超限自动 compact:上游(GLM 1261 等)拒收时,代理把错误归一化成 OpenAI
context_length_exceeded,codex CLI 收到后自动触发 compact 而不是退出。 - 余额接口自动探测:第一次刷新中转账号余额时按顺序 probe
/v1/dashboard/billing/*(new-api 系)→/v1/usage(sub2api / OpenAI 兼容)→ 都不通则不拉。探测结果落库,下次直接走对应 fetcher。 - 可观测配额:5 小时/周配额、token、成本、cache savings、切号原因、周期历史都能看。
- 月抛账号到期提醒:可为每个账号手工记录订阅到期日,列表直接显示日期,并对 7 天内到期和已过期账号醒目标记。ChatGPT / Codex 当前没有提供可信的订阅到期日接口,因此该日期与 OAuth token 到期、额度重置时间严格分开,不参与自动切号判断。
- 周期保鲜:所有 ChatGPT 订阅号默认自动管理,并按
/wham/usage返回的primary_window.limit_window_seconds自动识别 5H 或 7D,不绑定 Plus / Pro / Team 套餐名称;可在账号行单独关闭。系统只对无法确认已激活的 100% 窗口生成一次启动事件(极小请求可能因取整仍显示 100%);明确低于 100% 的窗口不补发。之后额度缓存跨过对应reset_at时生成下一事件。唯一权威端先持久化防重水位,再发一次极小 Codex 请求并重拉 usage。同一事件即使超时或报错也绝不自动重发;client/solo 模式只由 Server 执行。 - 长期开发友好:session affinity 保住 prompt cache,
prompt_cache_key按账号隔离,减少切号后的缓存污染。 - 跨工具 Skills:把 Codex/Claude/Gemini/OpenCode 的 Skills 统一发现、安装、同步。
- 界面预览
- 为什么需要它
- 工作方式
- v0.7.16 更新说明
- v0.7.14 更新说明
- v0.7.13 更新说明
- v0.7.12 更新说明
- v0.7.11 更新说明
- 周期保鲜
- 推荐组合:GLM Coding Plan + glance
- 核心能力
- 功能点速览
- 界面模块
- 账号导入方式
- 兼容矩阵
- Provider 清单
- 典型使用方式
- 安装
- 从源码运行
- 数据和安全边界
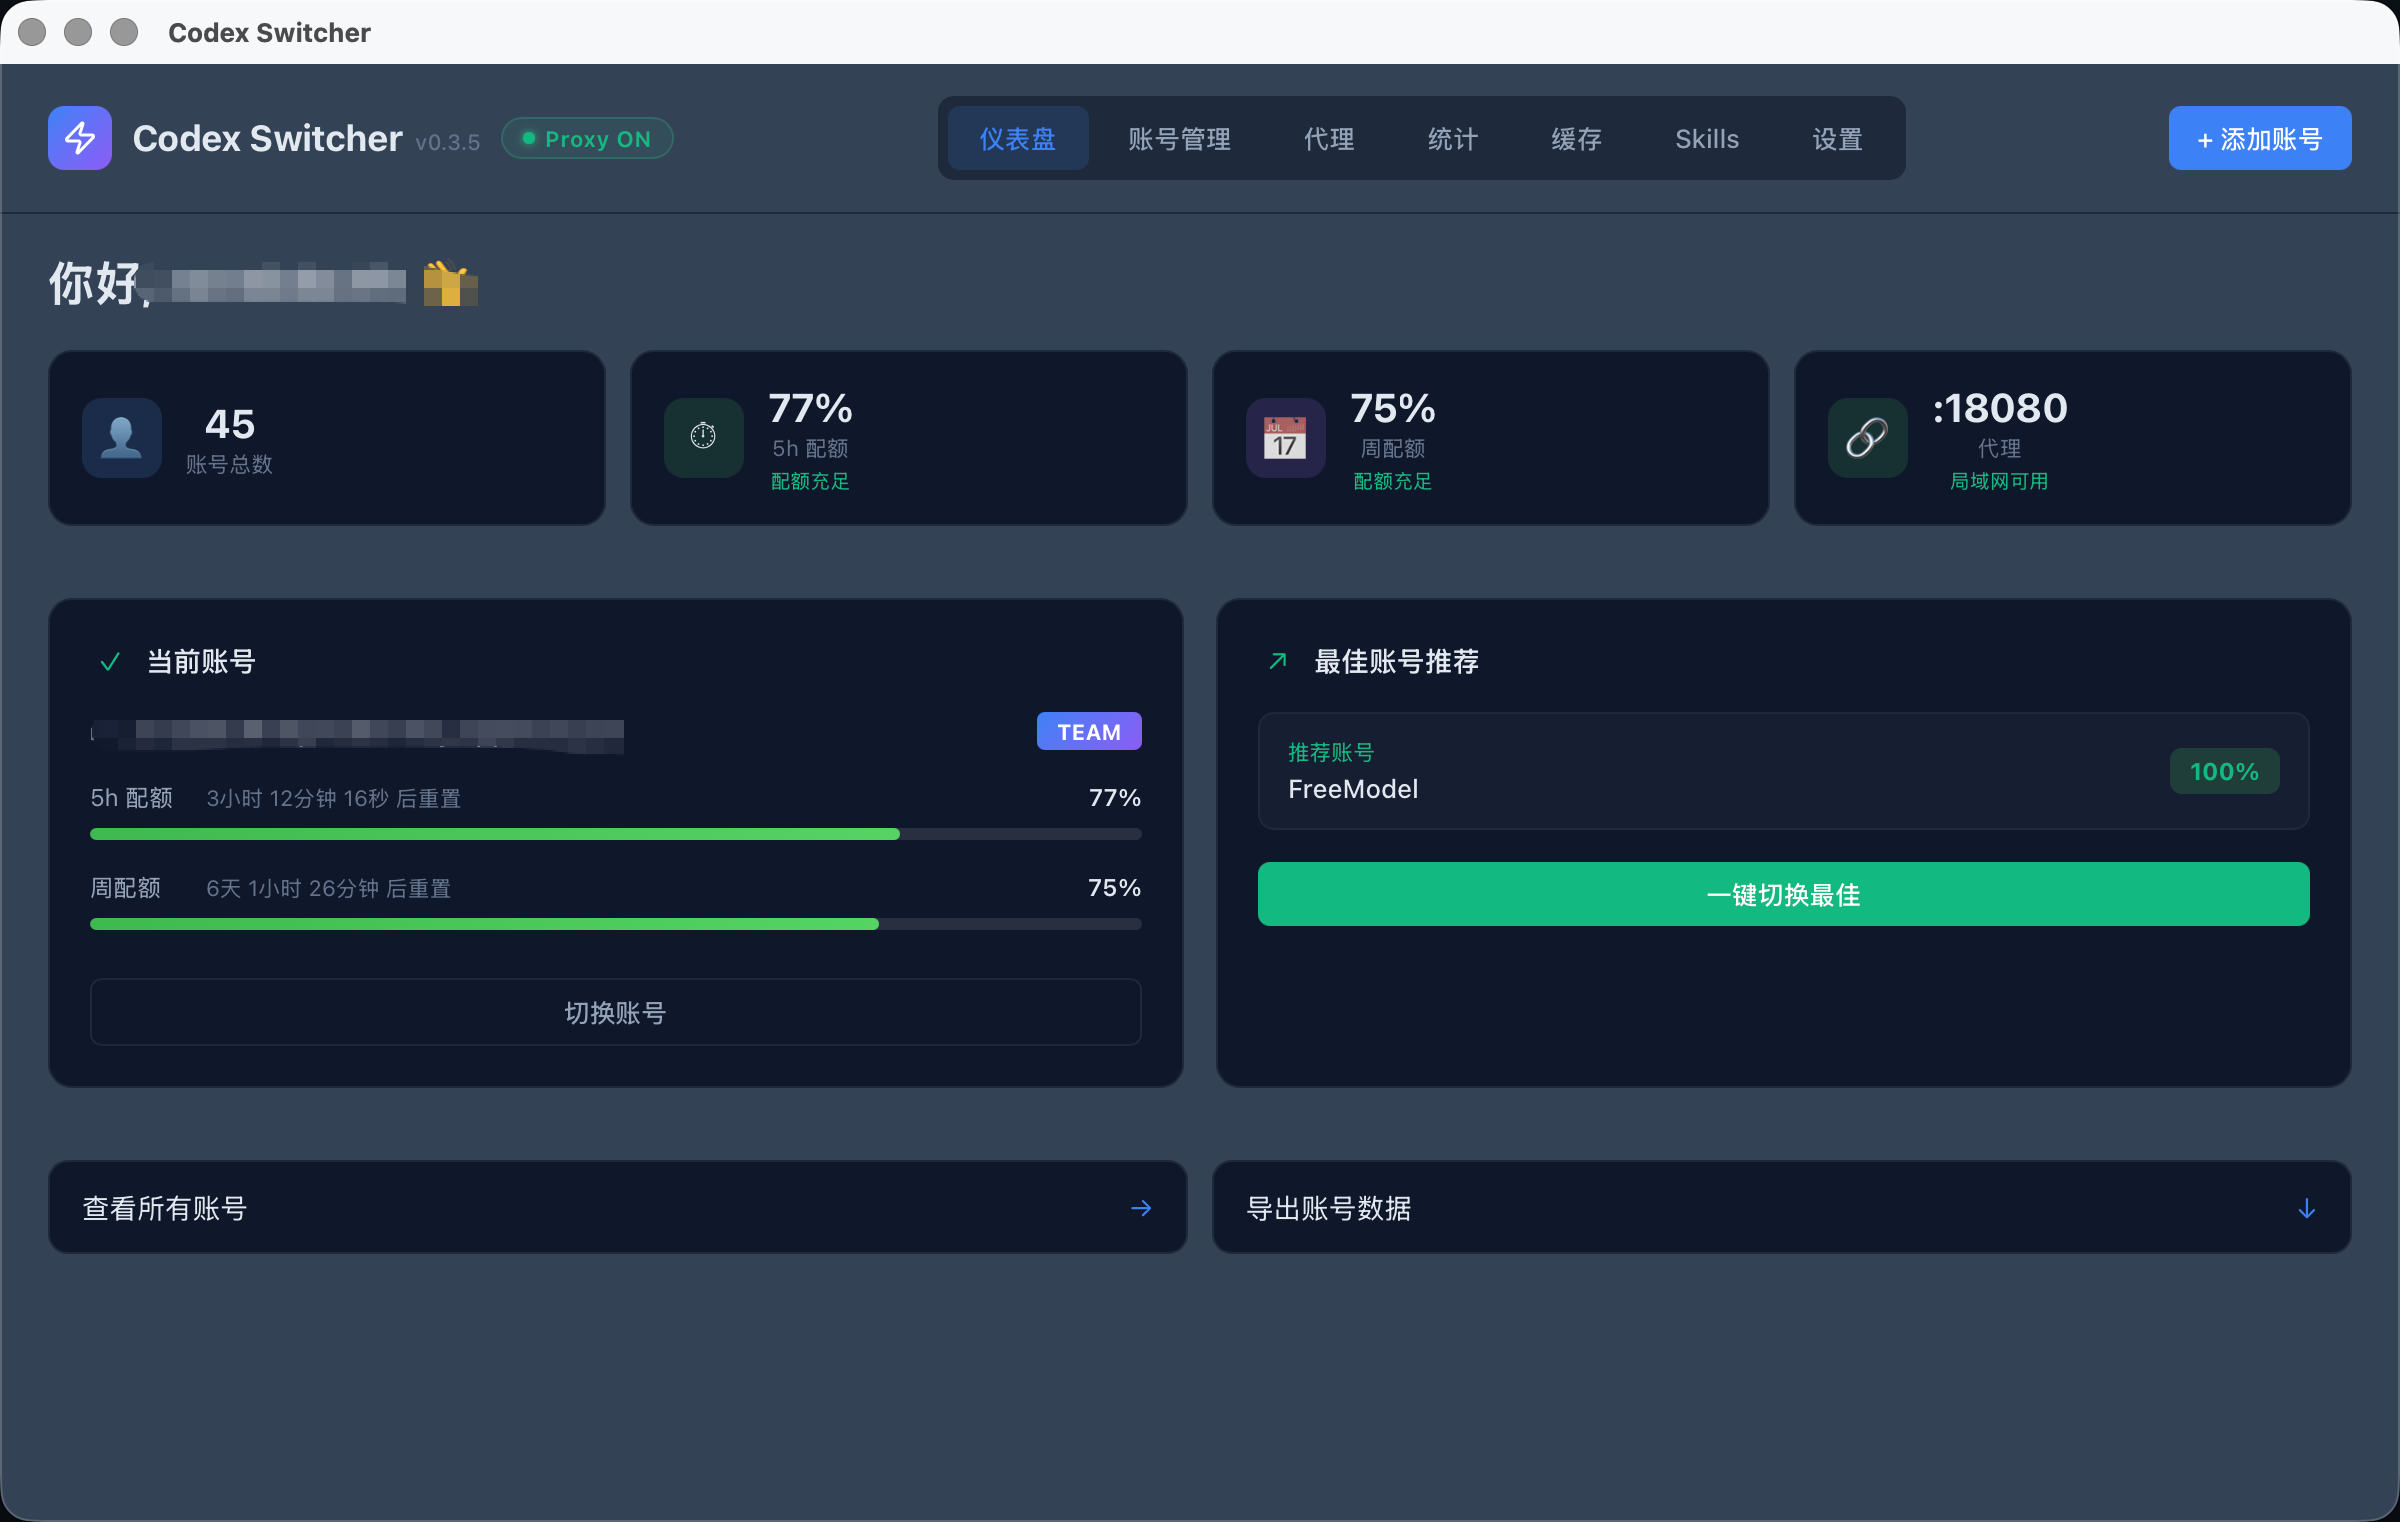
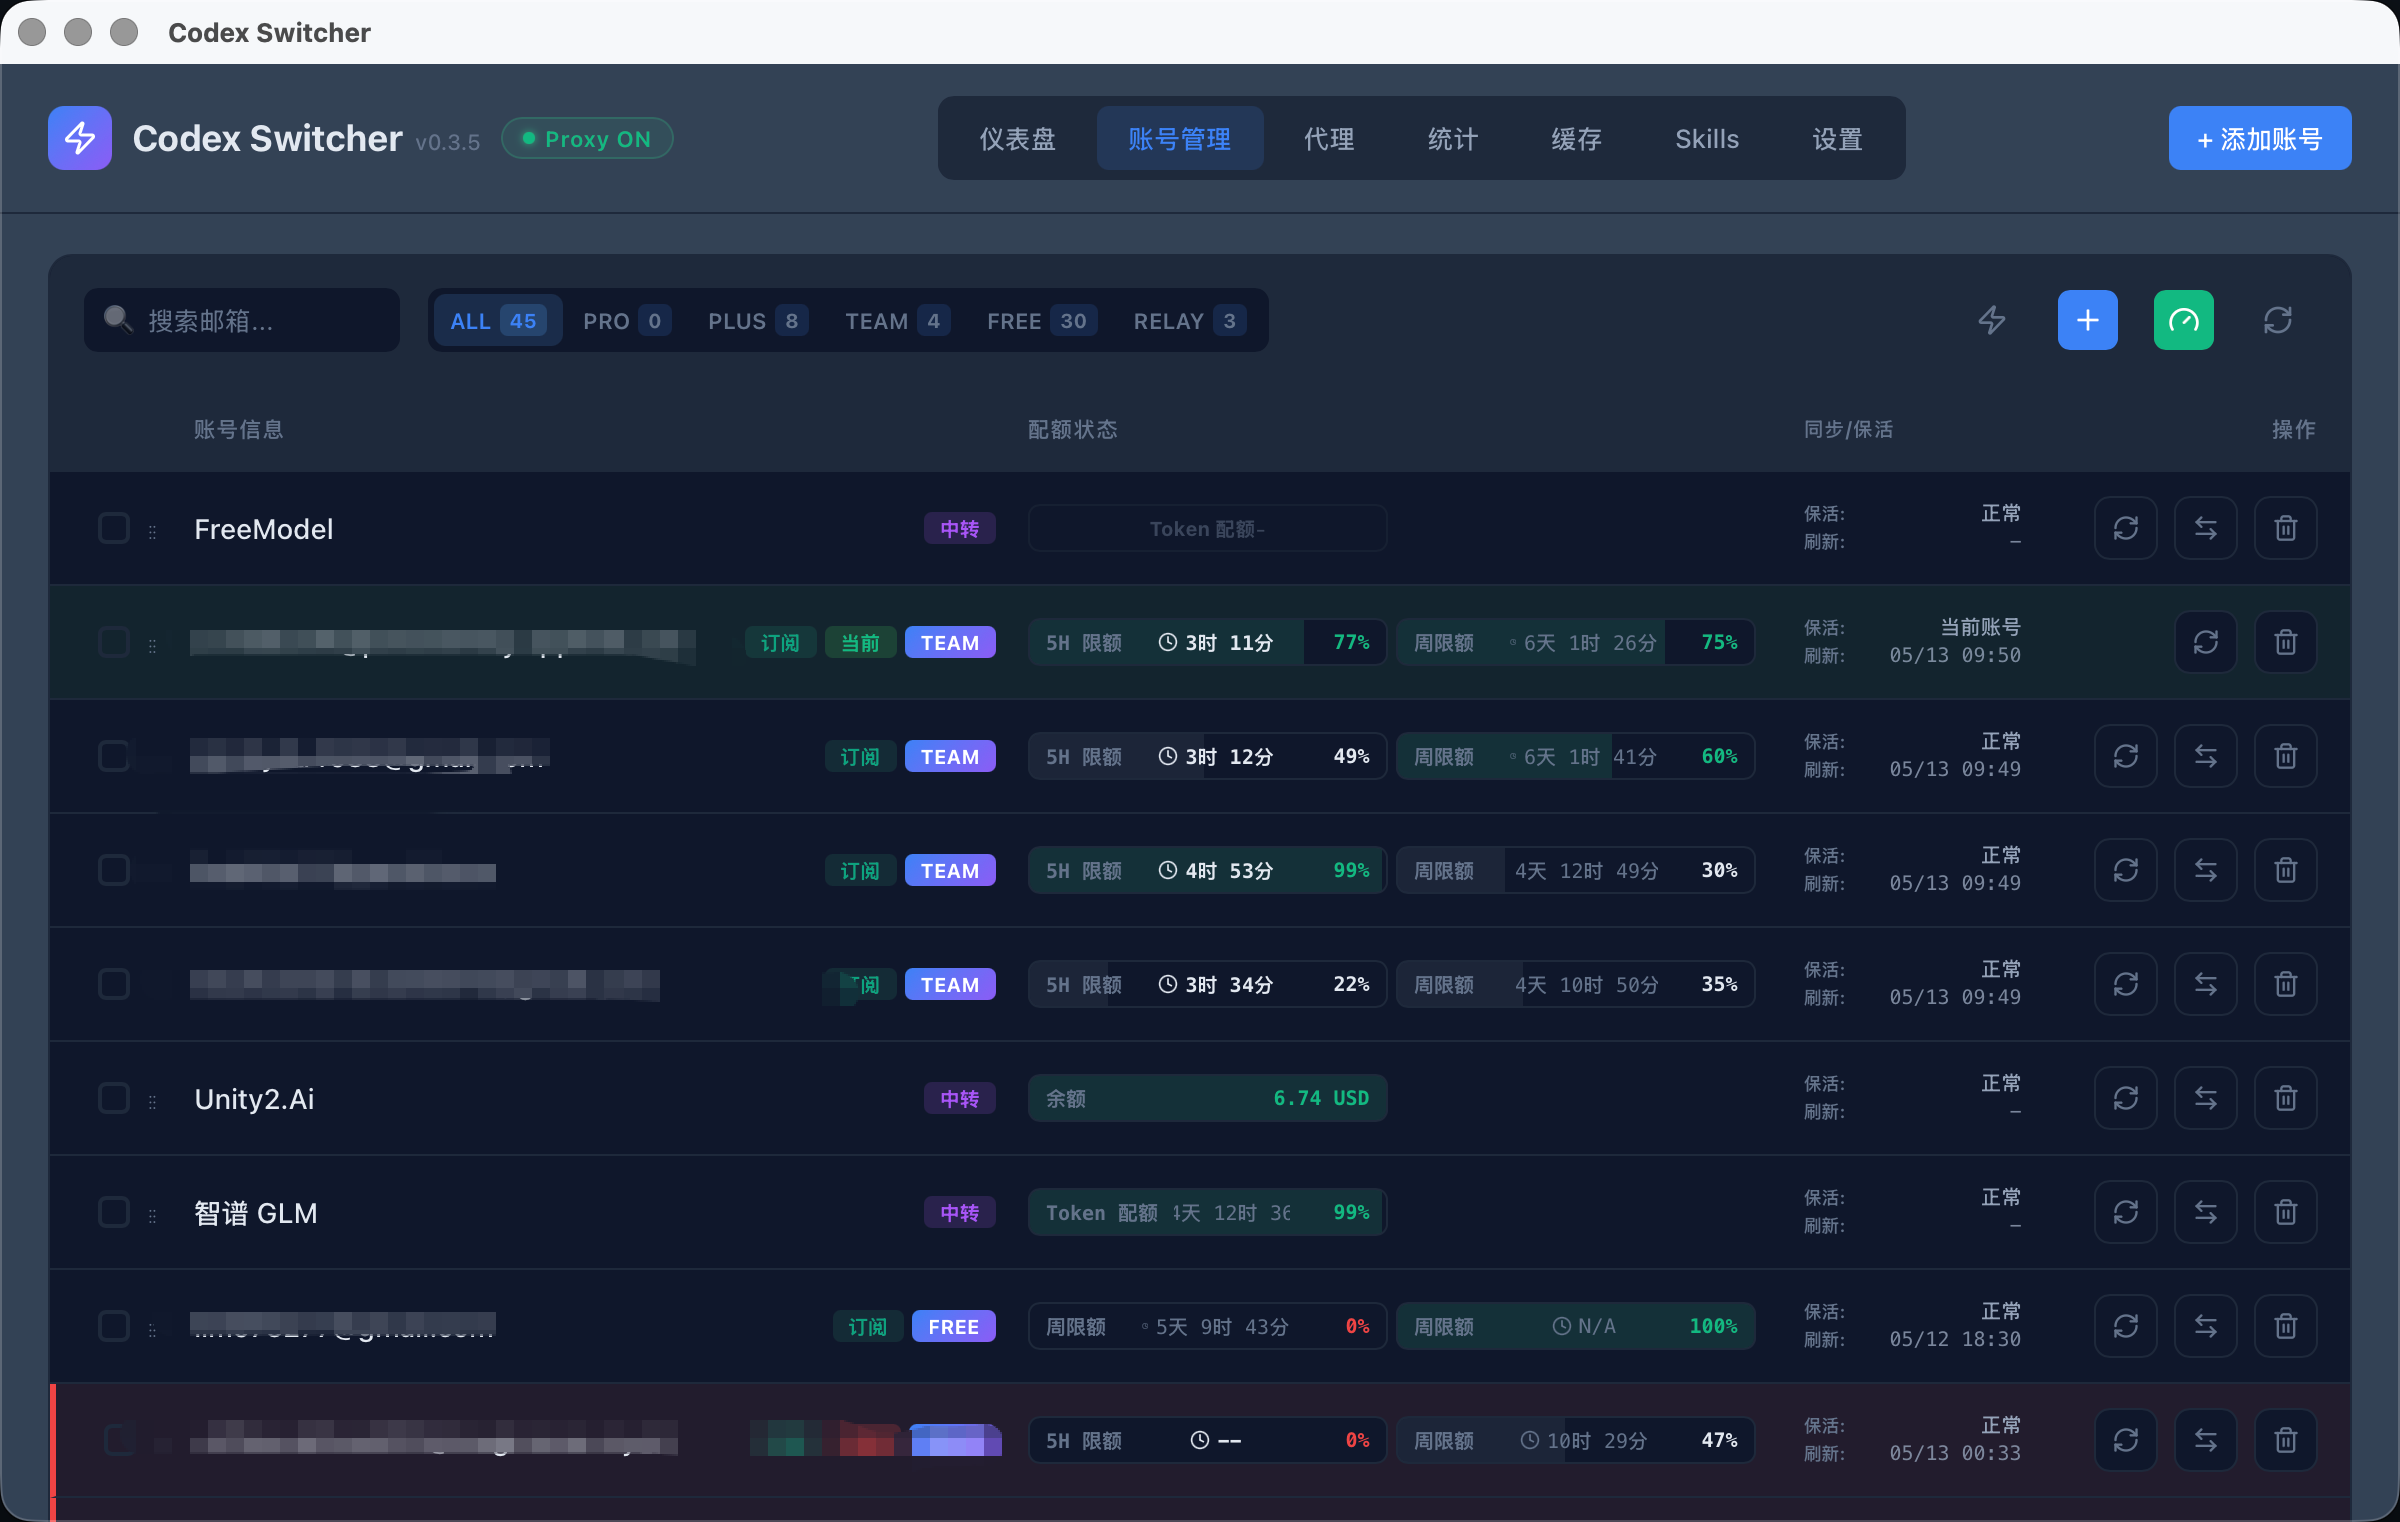
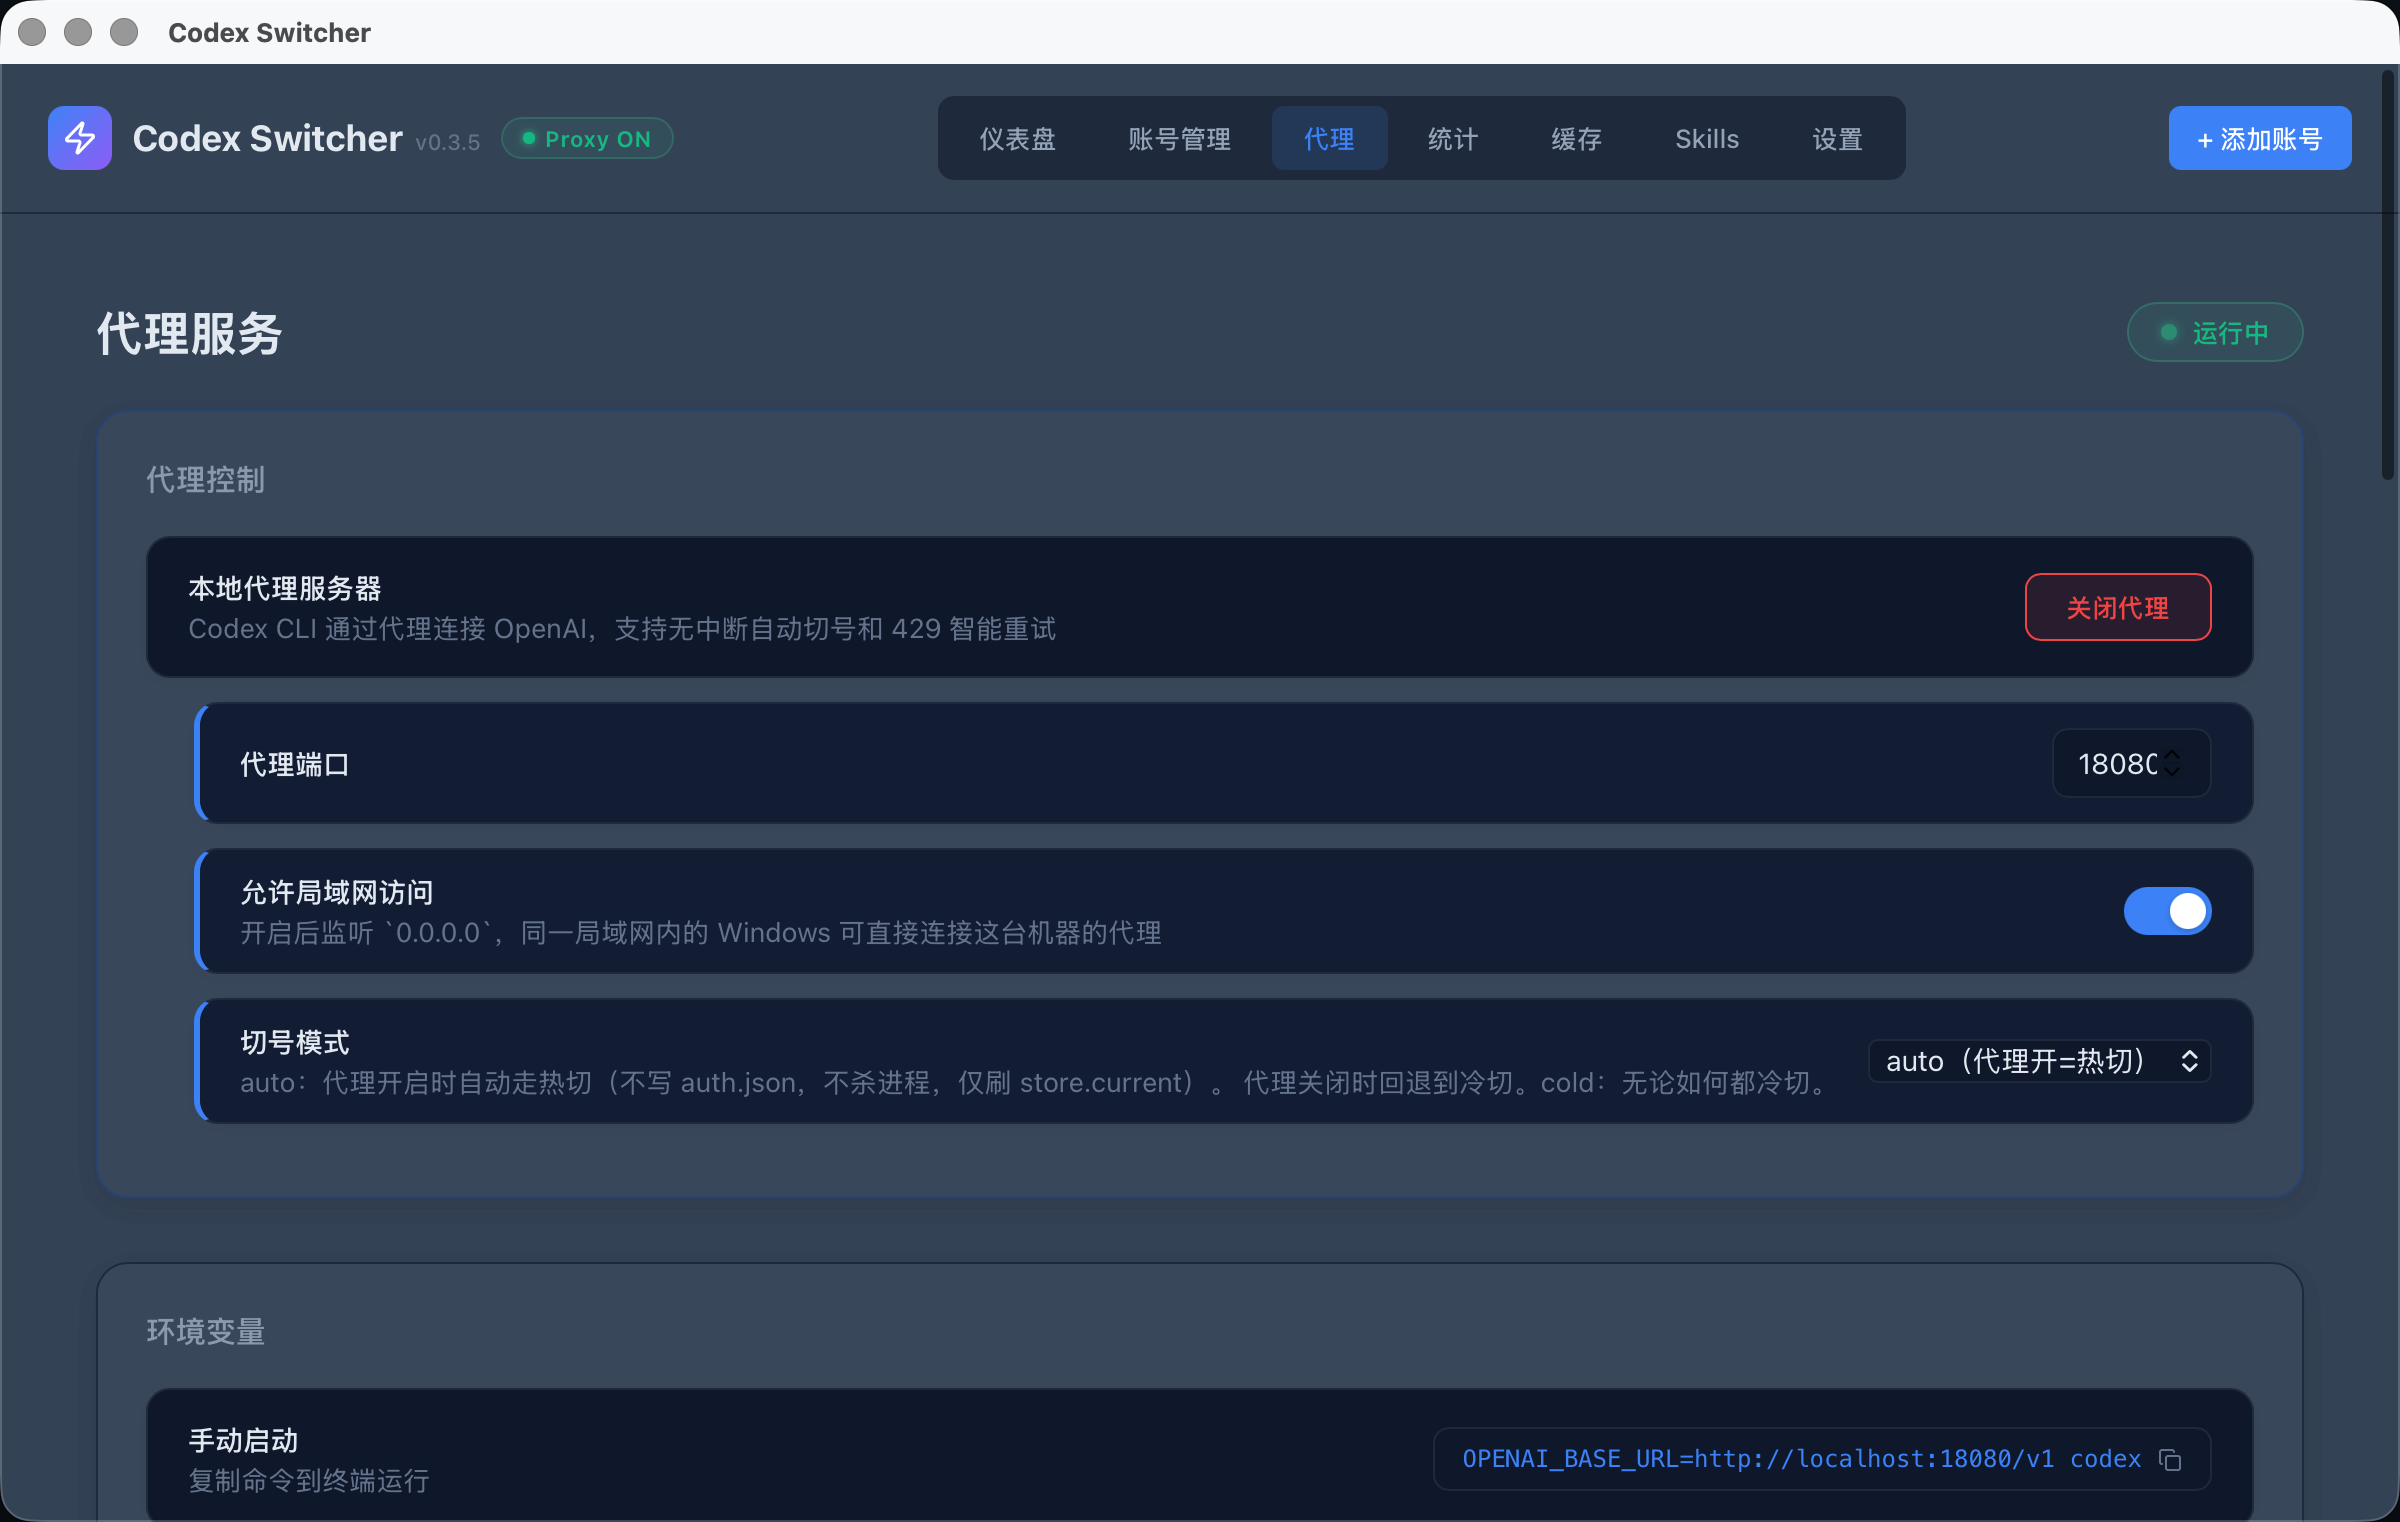
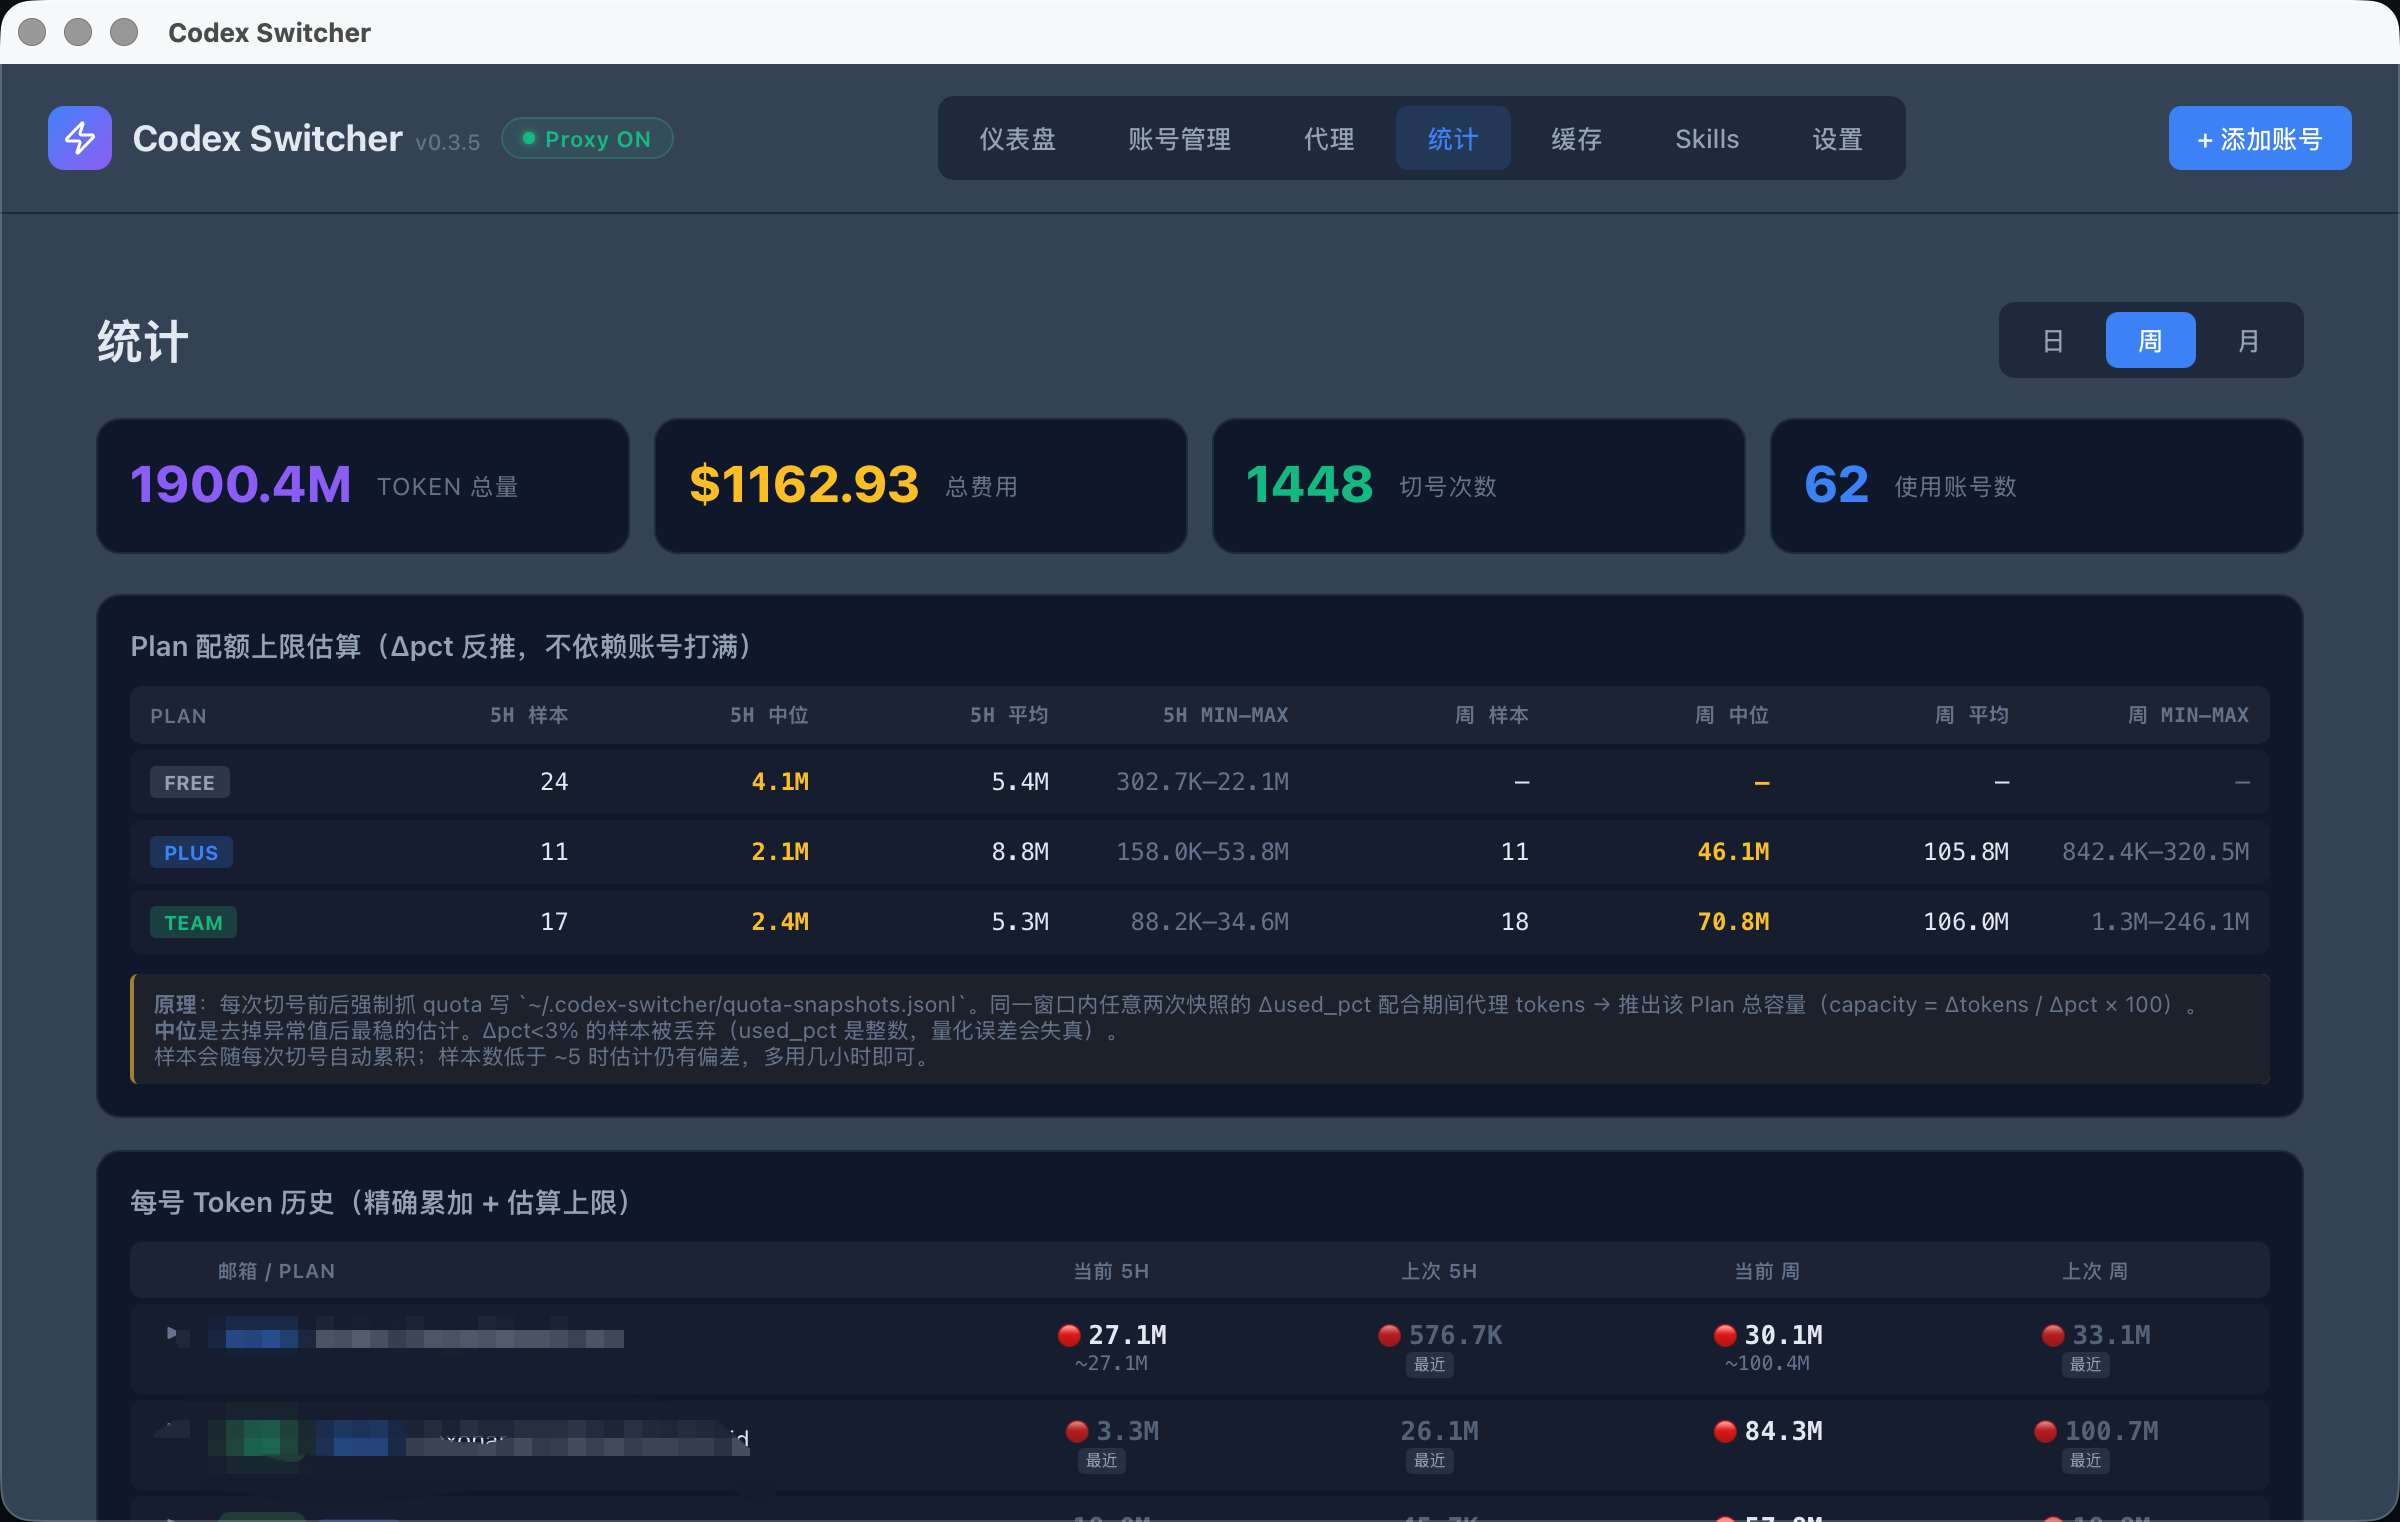
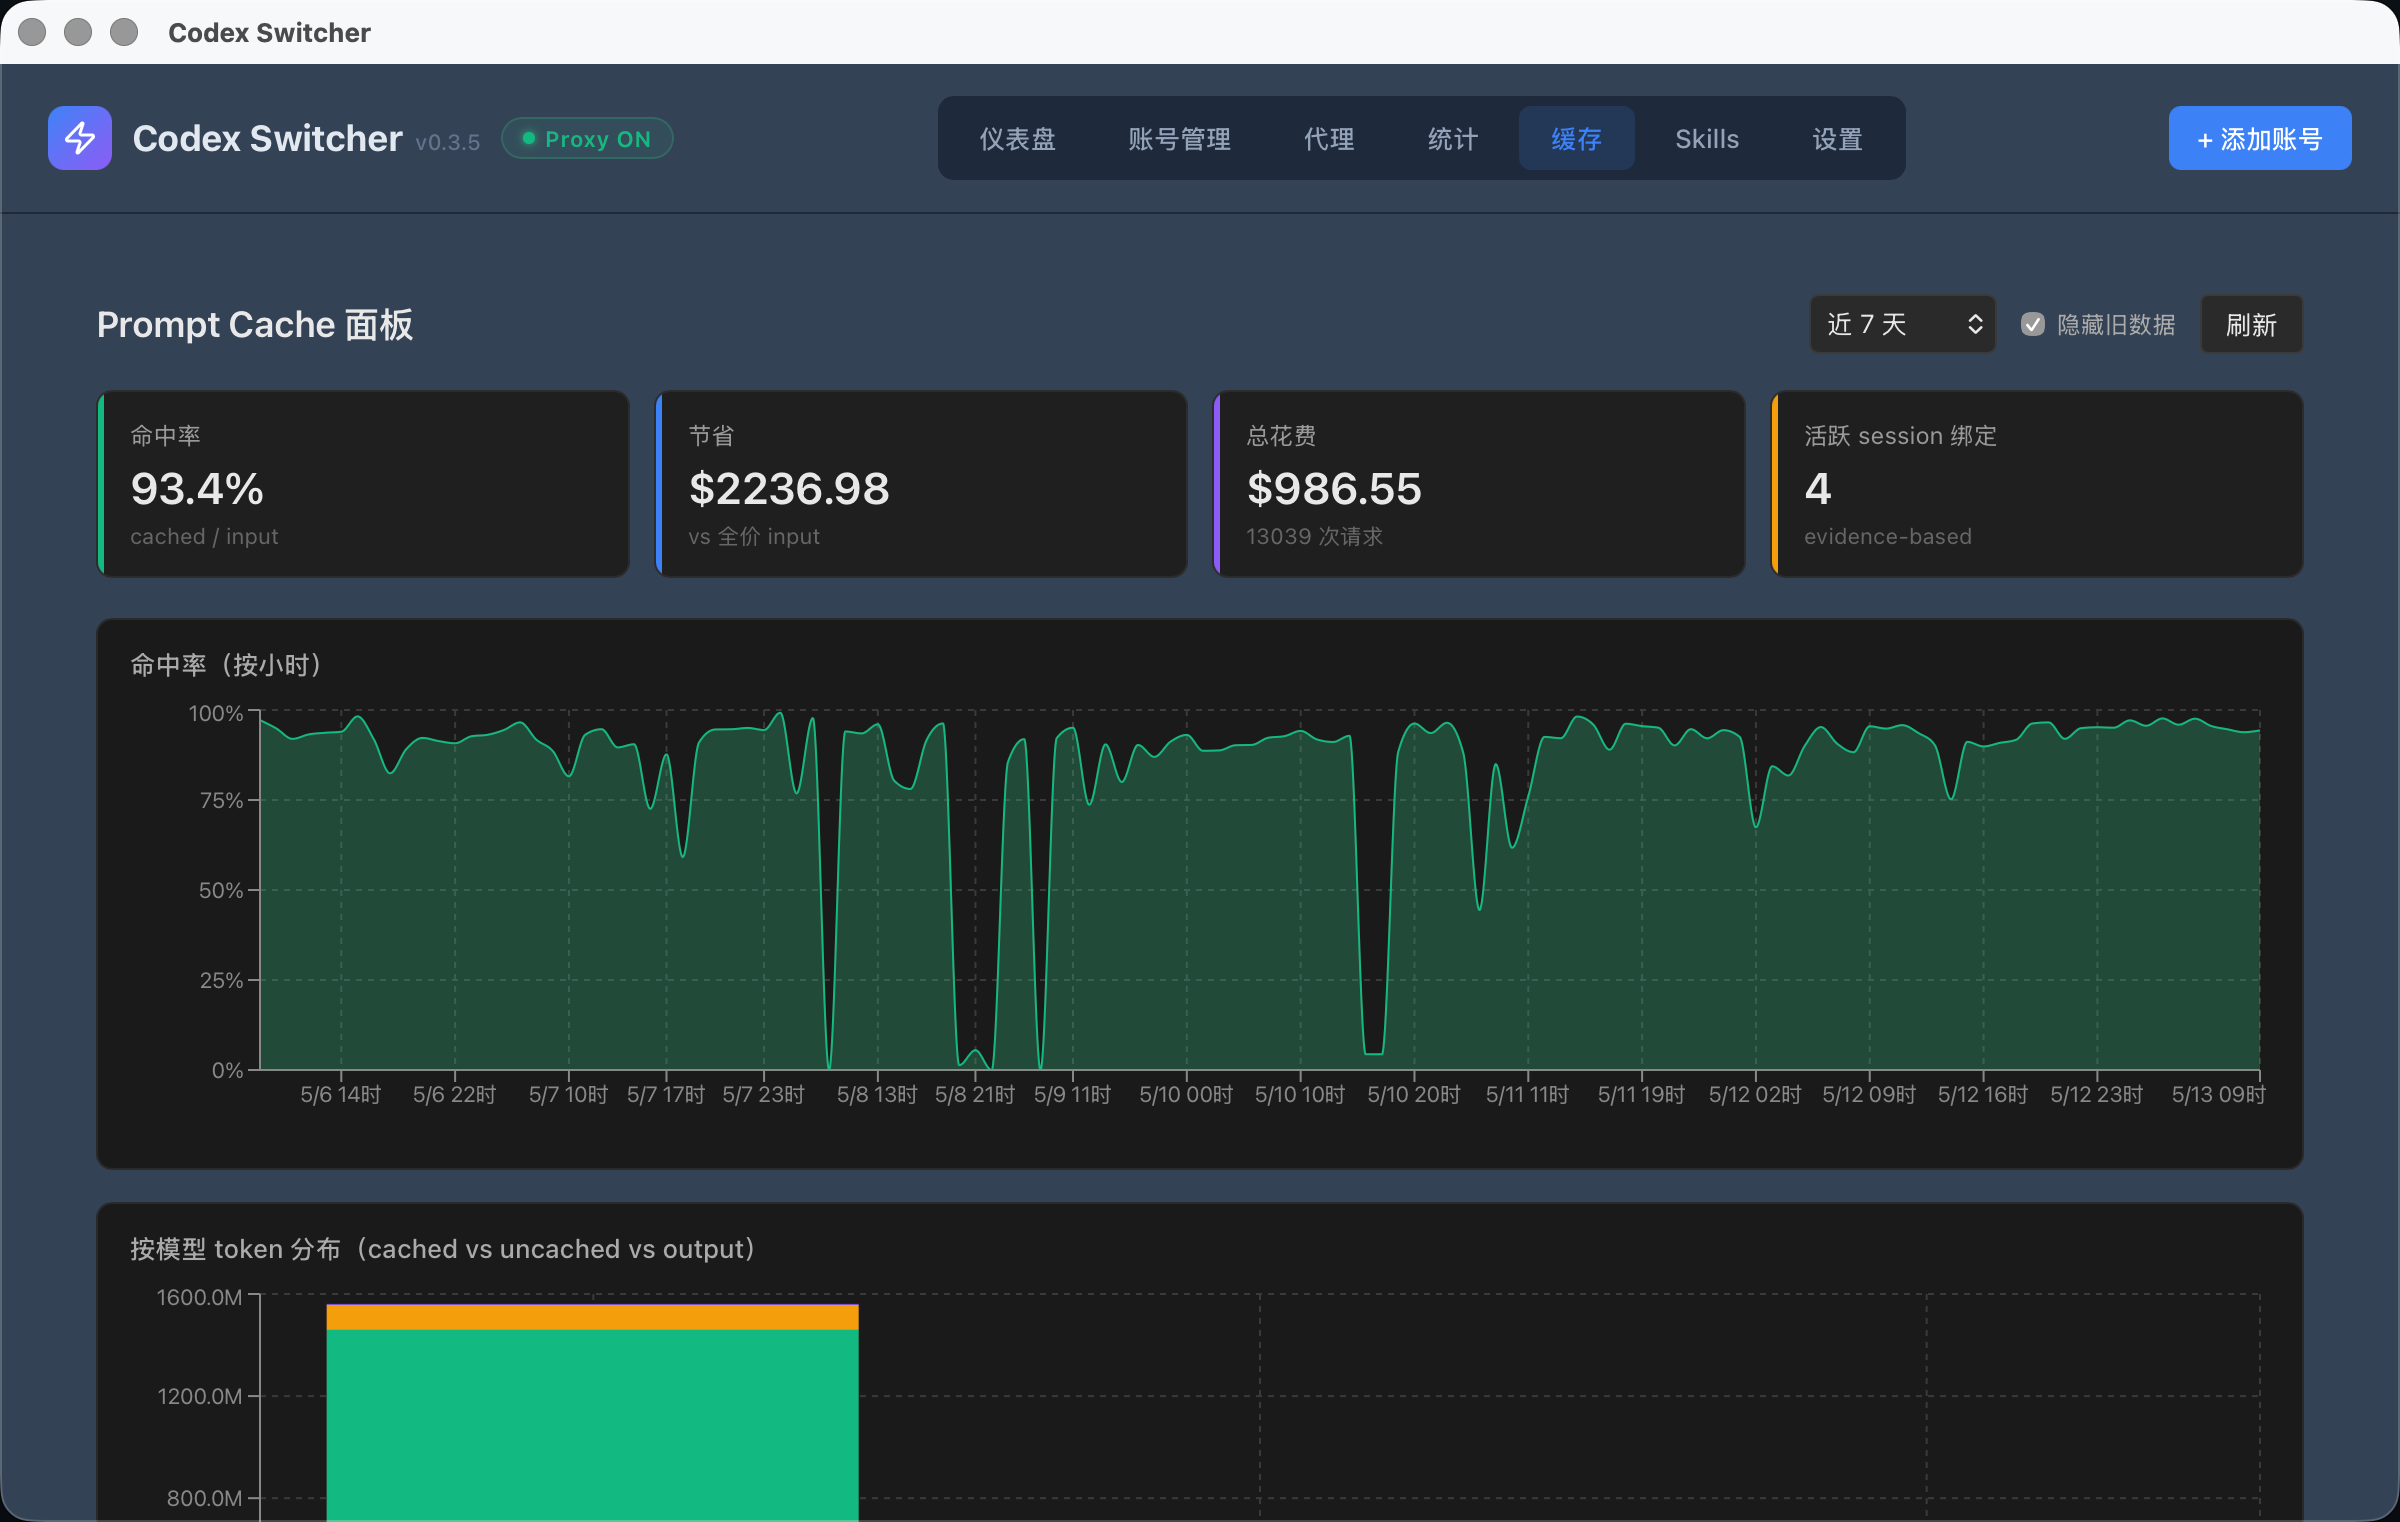
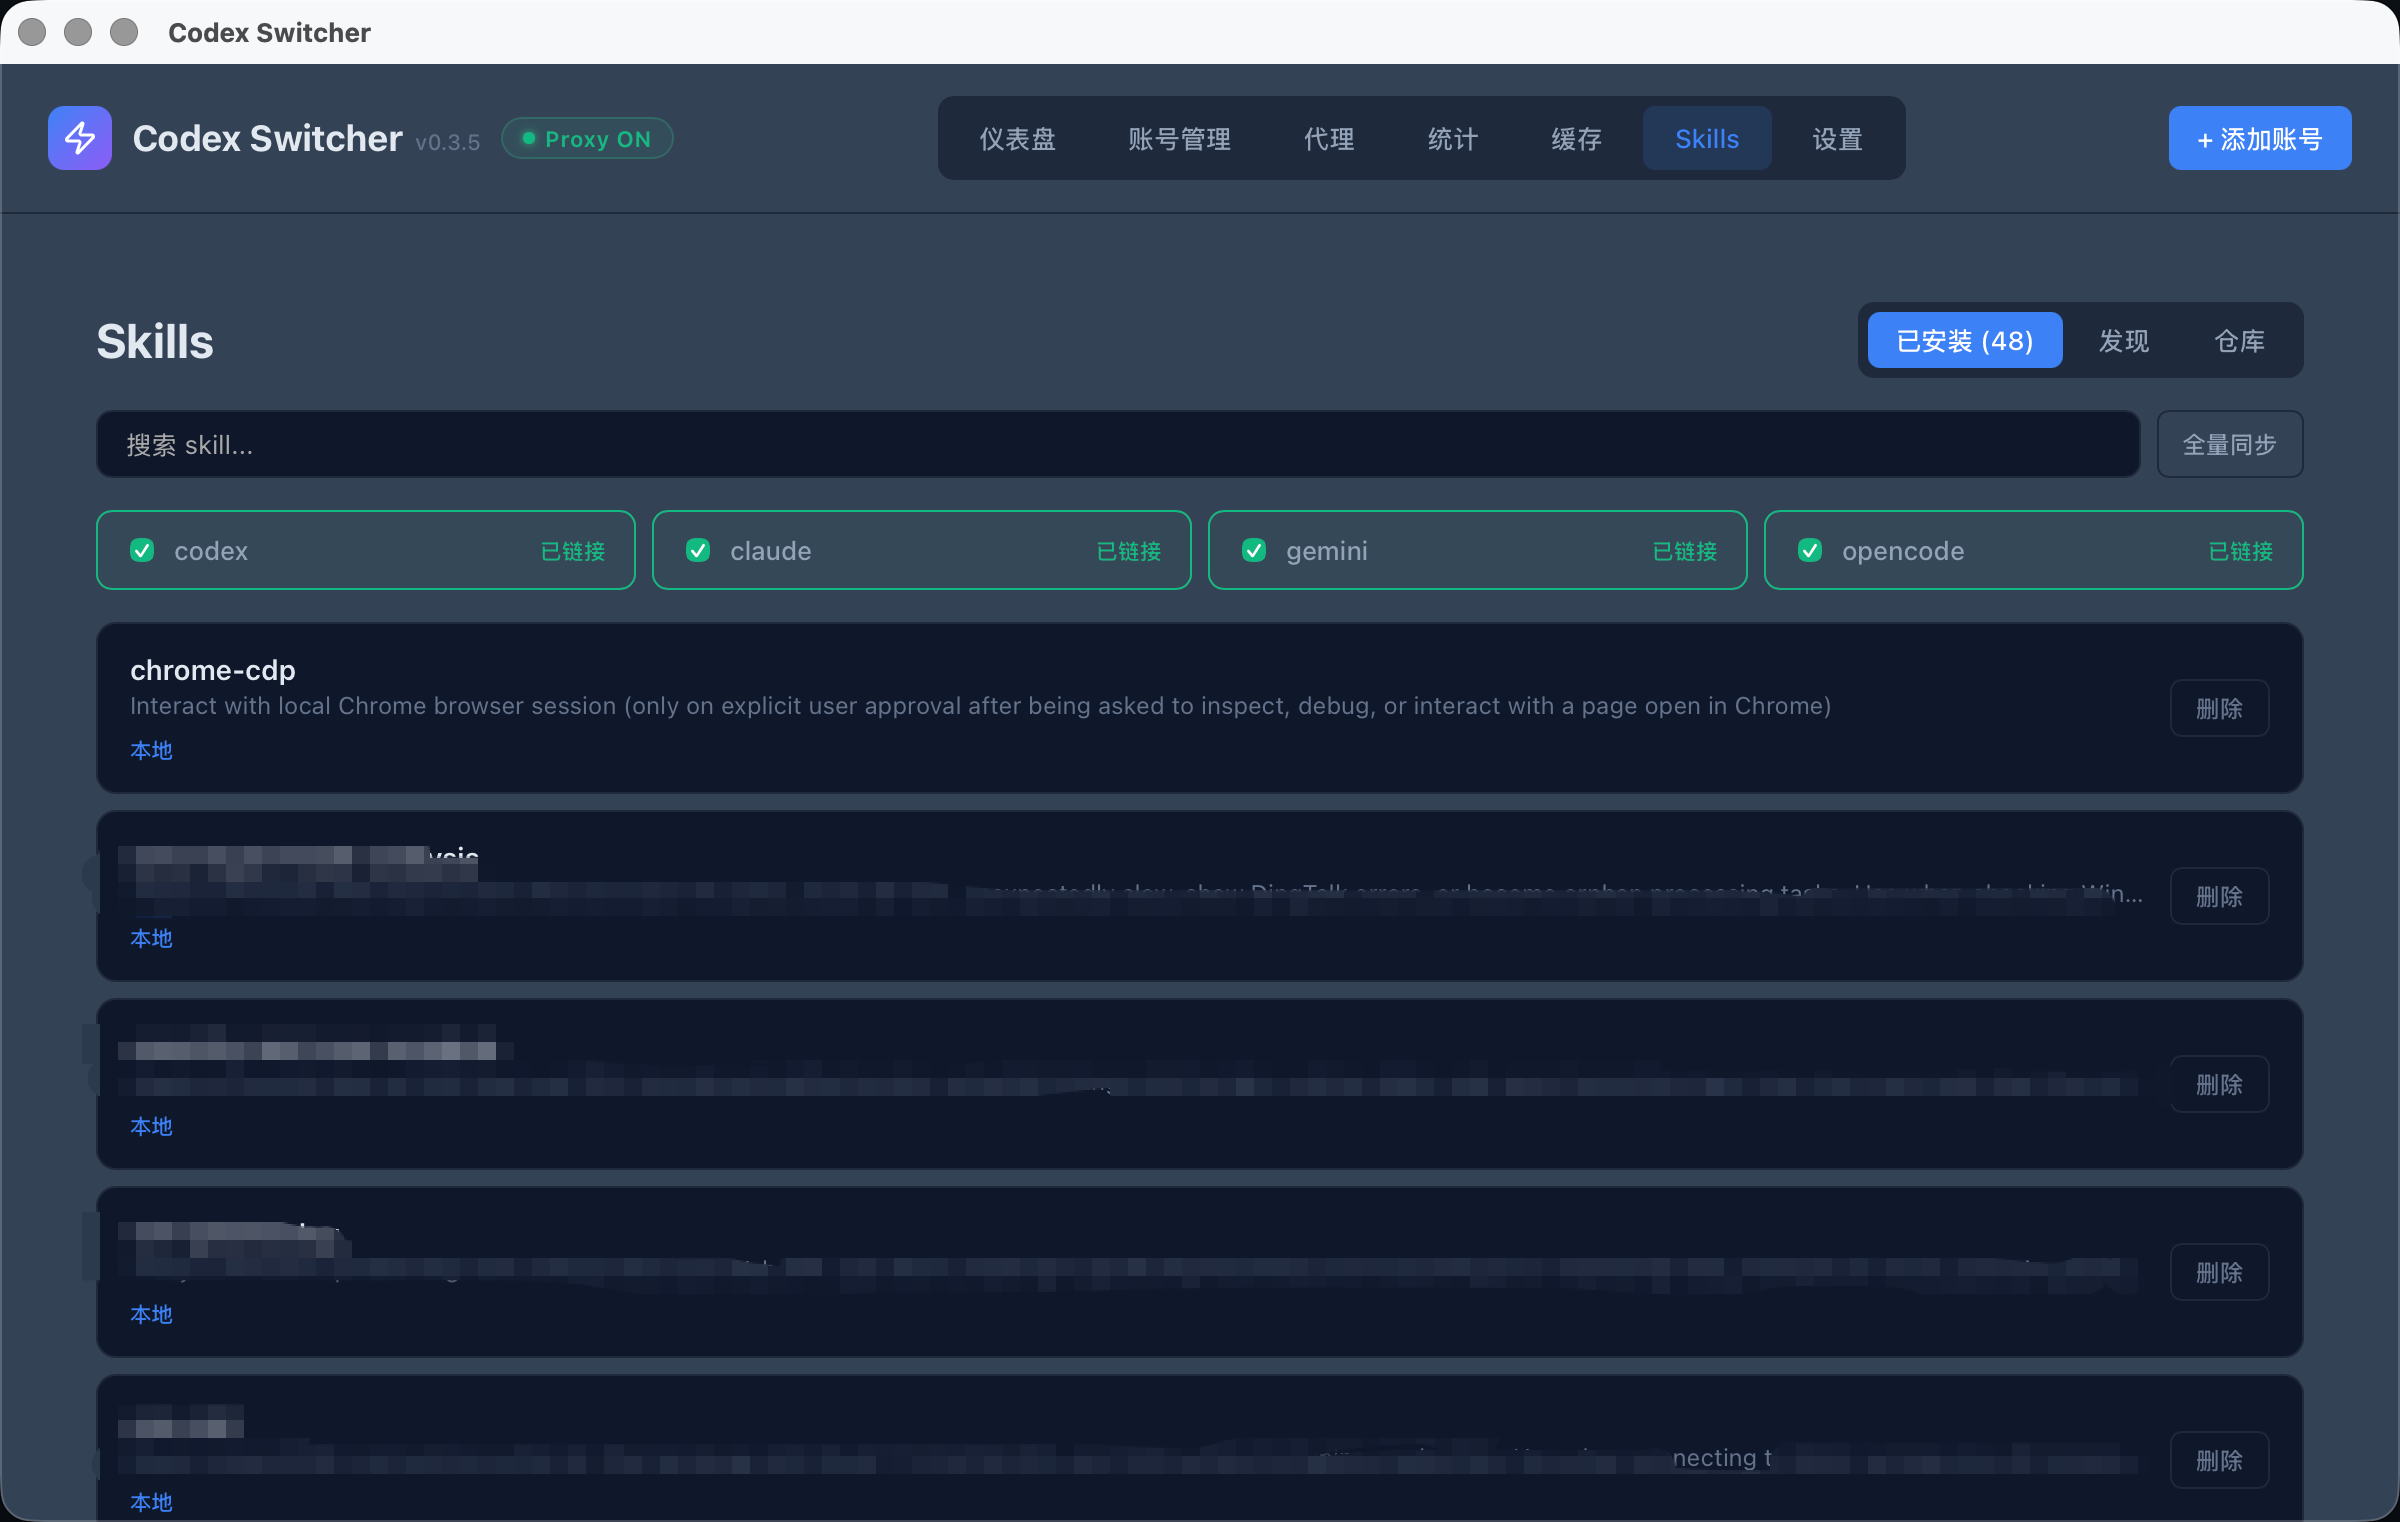
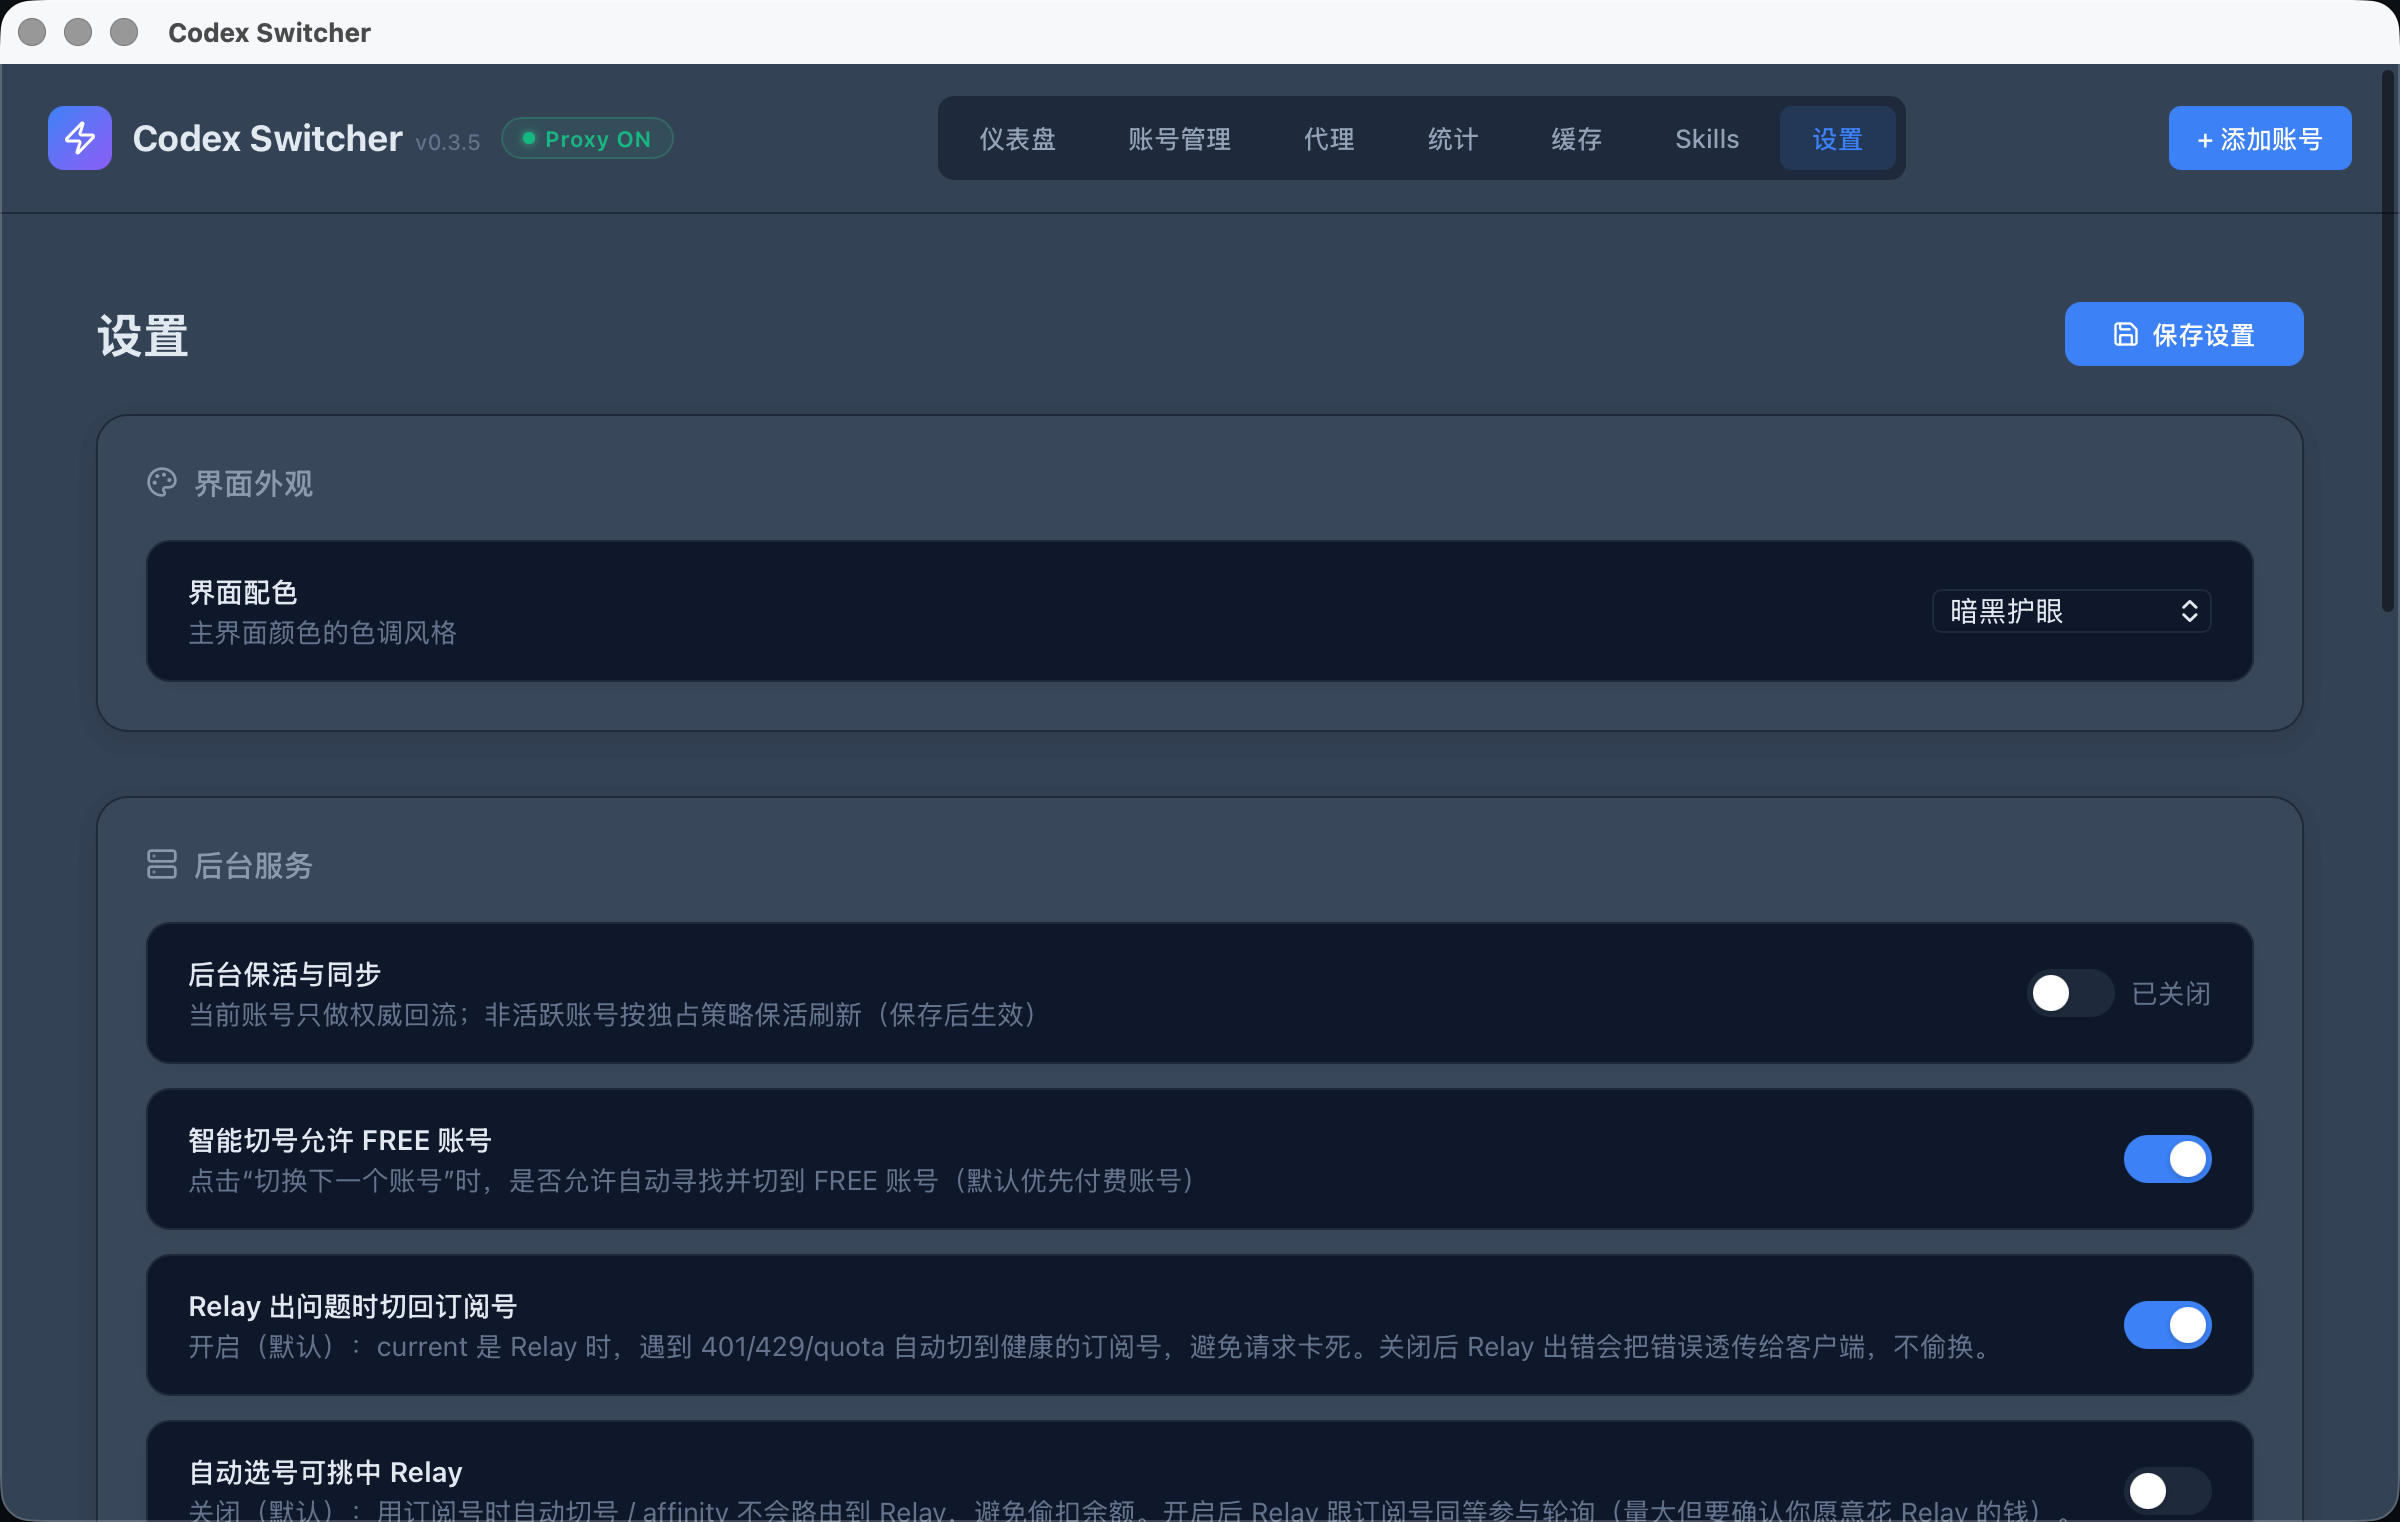
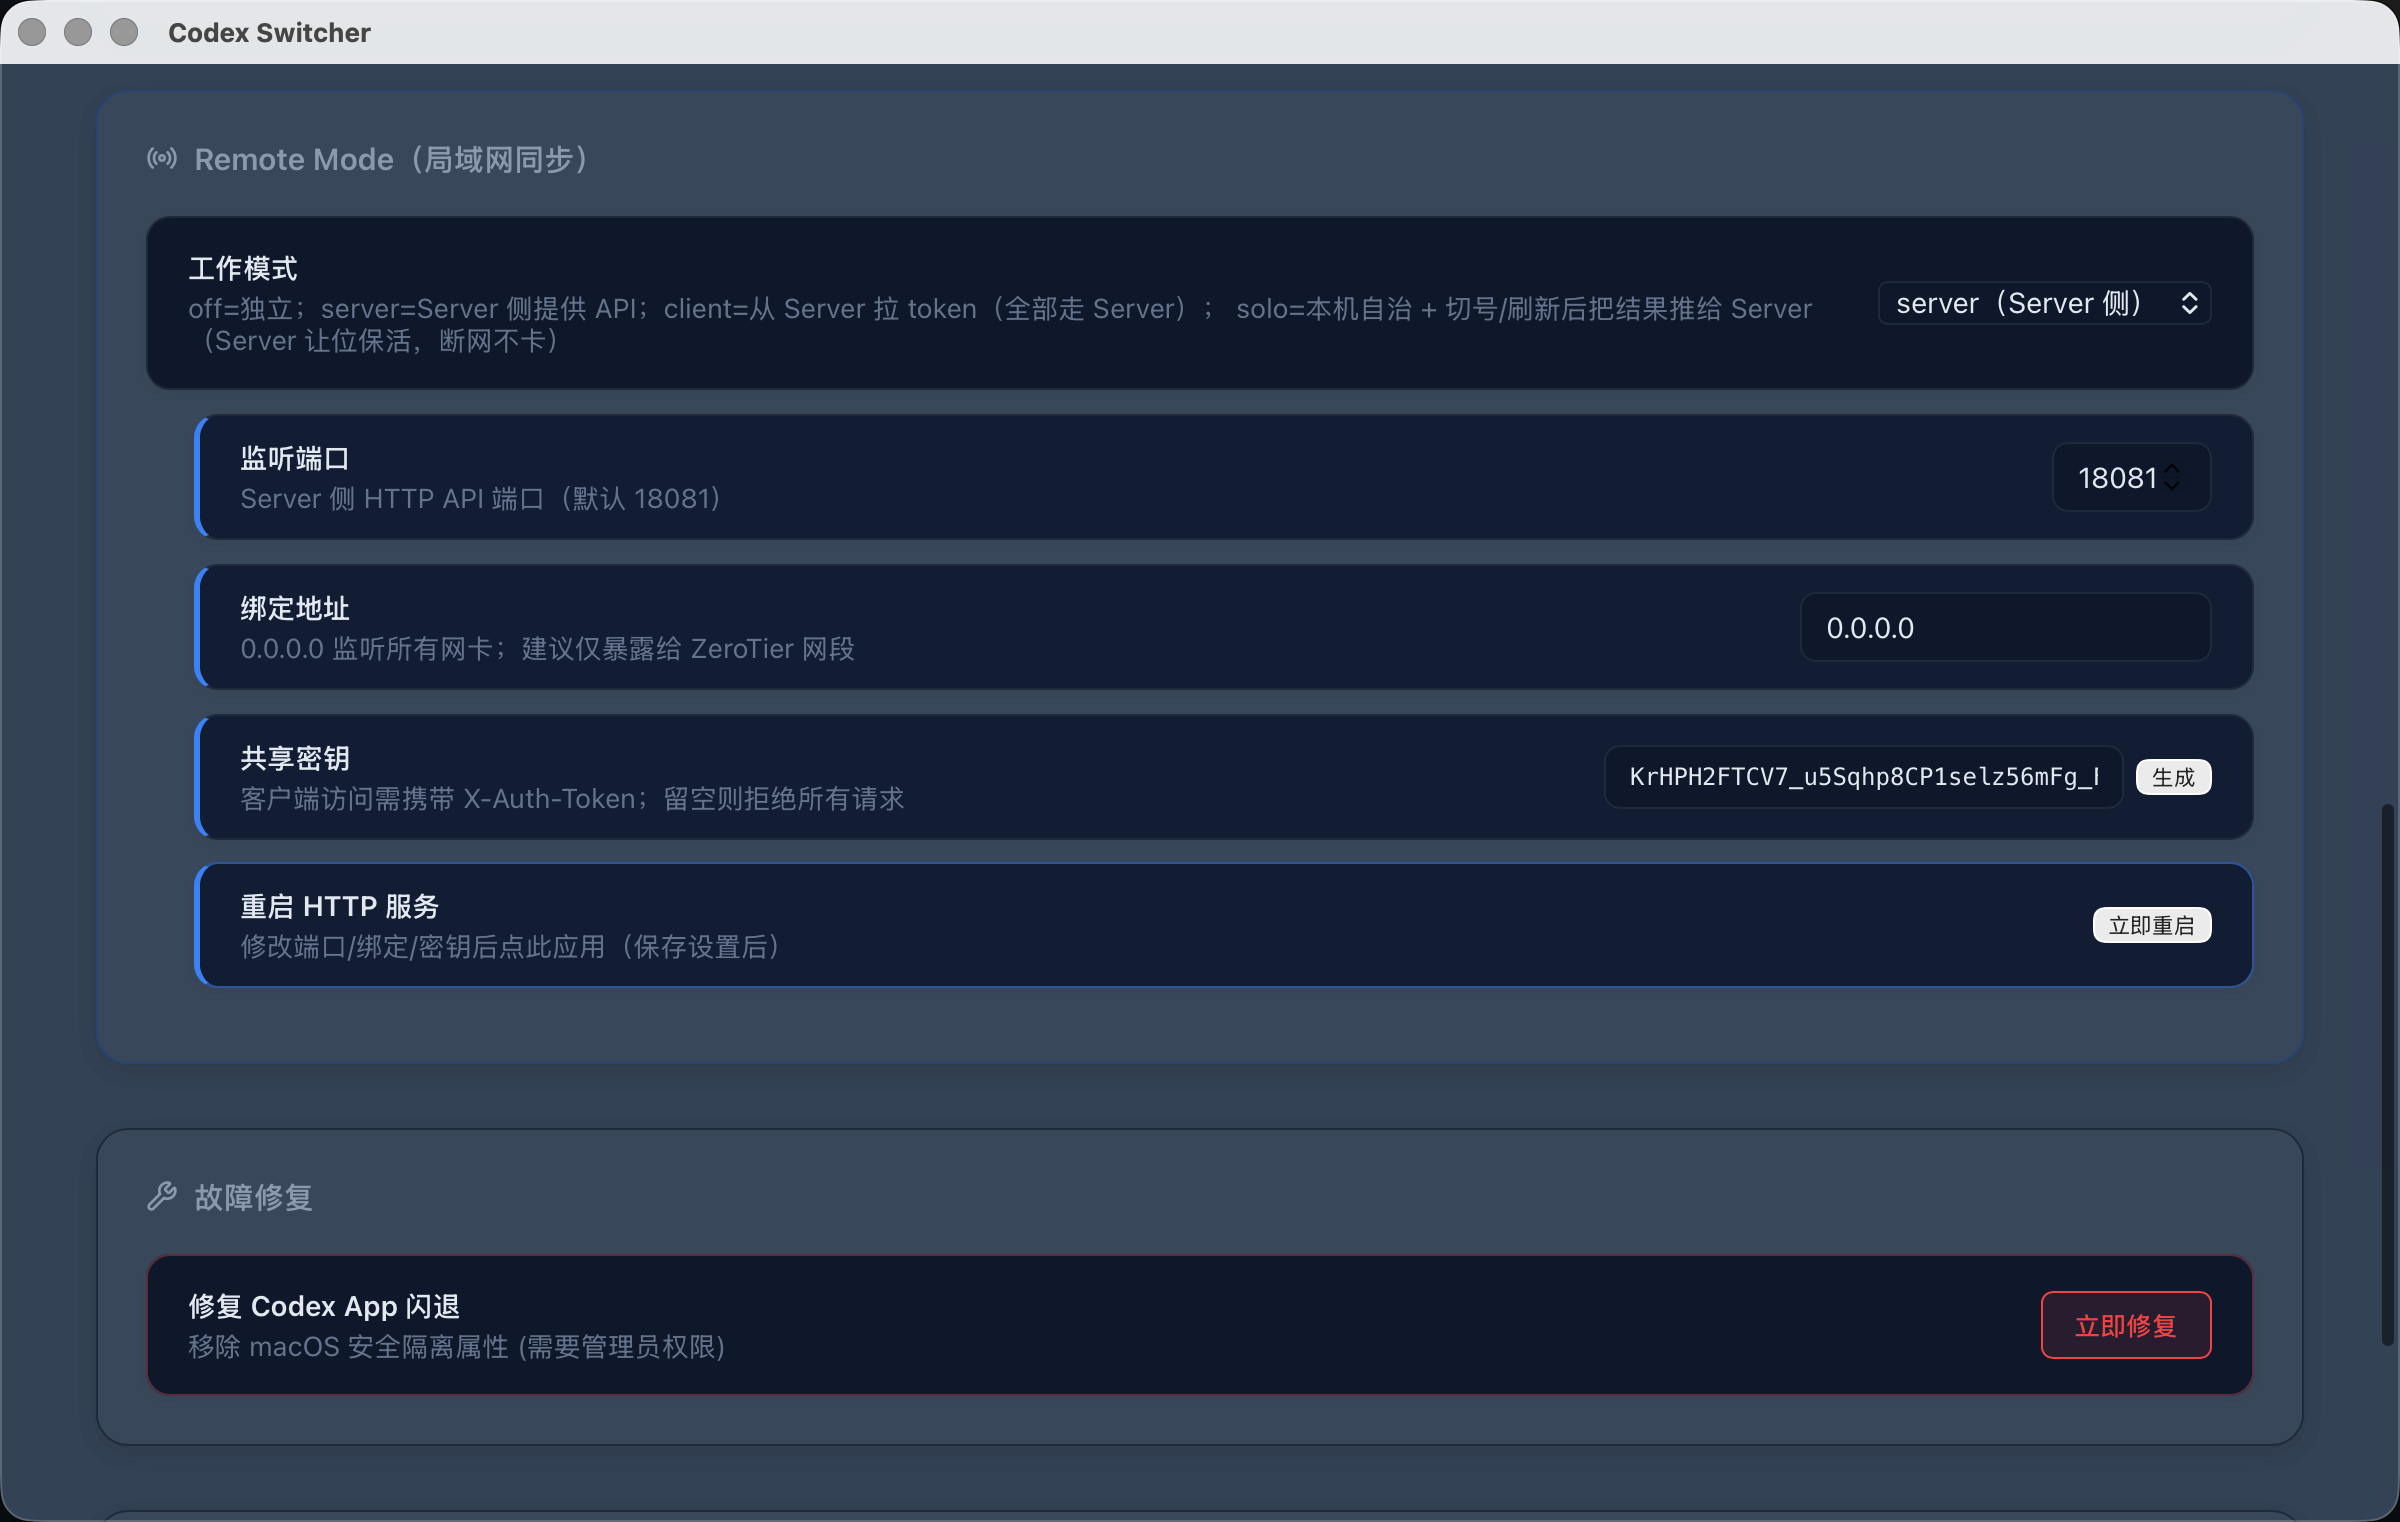
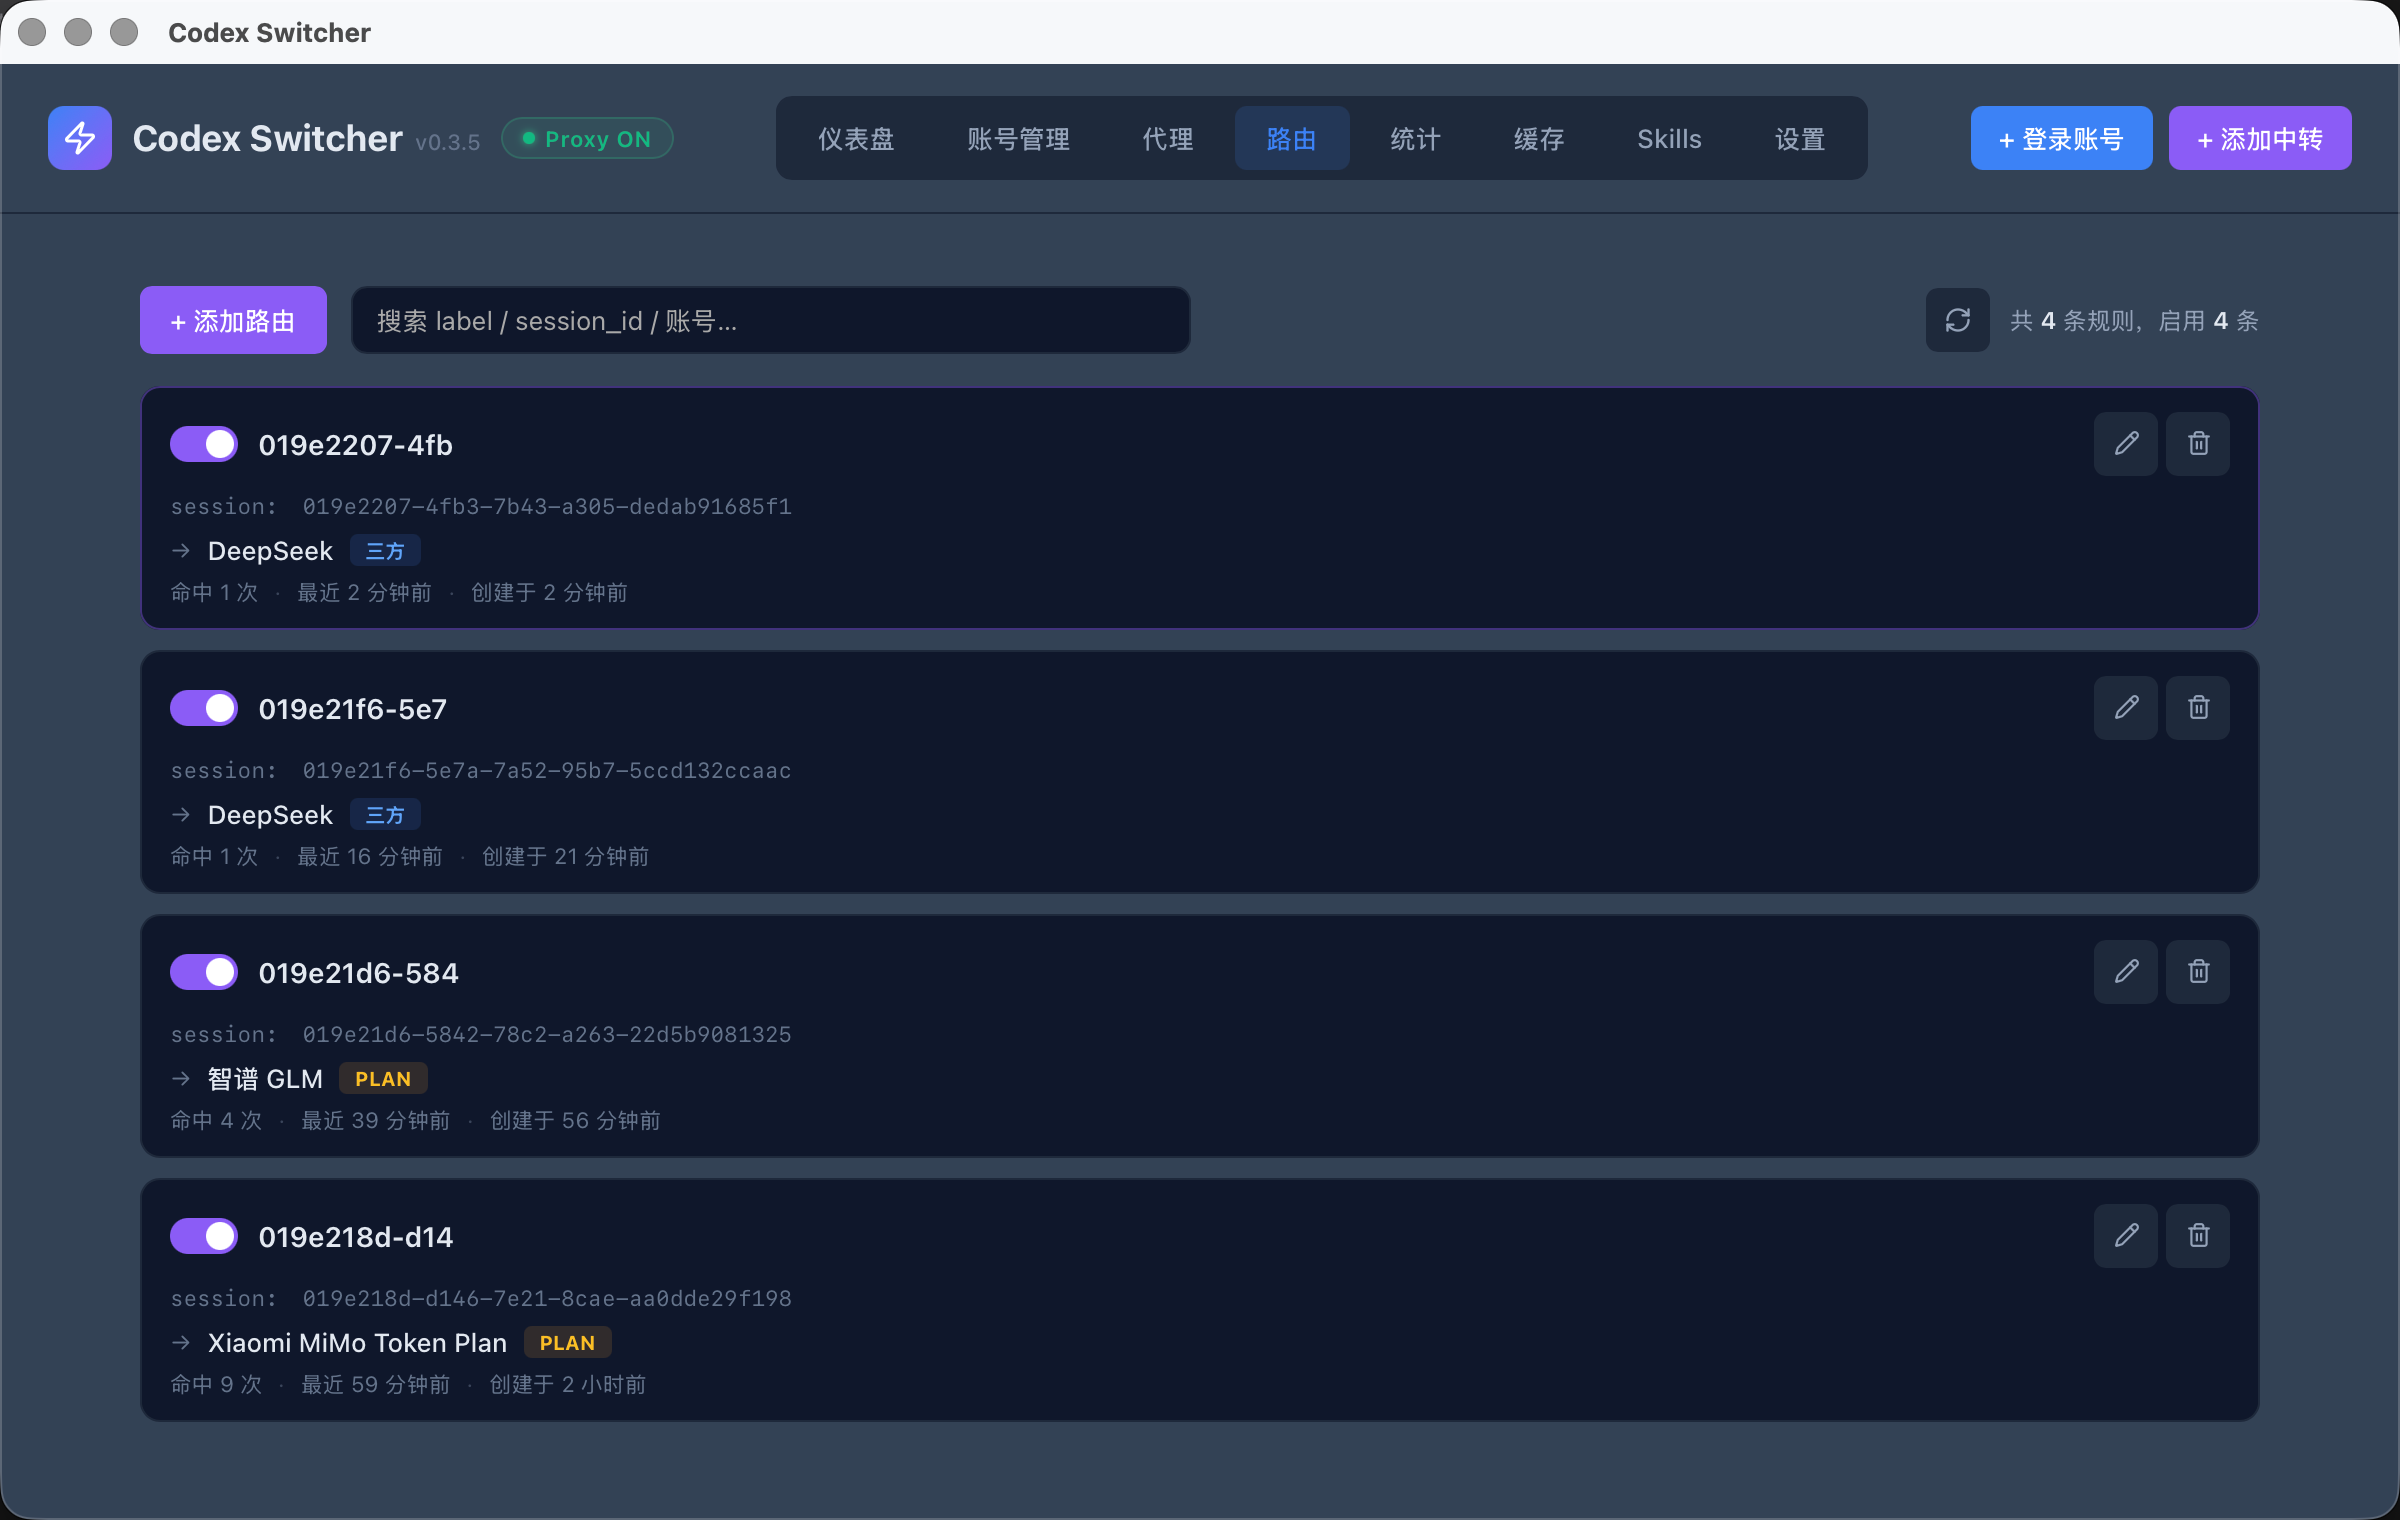
Codex CLI 的账号、配额、Token、缓存和代理问题通常是分散的:一个工具负责登录,一个脚本负责切号,一个代理负责转发,另一个表格记录用量。Codex Switcher 把这些动作收在一个桌面应用里,并且在代理层真正理解 Codex 请求流。
它不只是“换 auth.json”。它的王炸功能是:无损切号。
- 当前账号触发限额、封禁、401、全局容量不足时,代理层可以自动选下一个可用账号。
- 前端软件无感知,不需要用户手动复制 prompt、重启任务或重新发起请求。
- 对可重试场景,代理会在后台换号并重发请求,客户端看到的是一次连续请求。
- 能把 Codex 的
/v1/responses请求实时翻译成 OpenAI/chat/completions,让 GLM Coding Plan、Xiaomi MiMo Token Plan 这类并不完整支持 Codex Responses 协议的服务也能接入。 - 能在 SSE 流还没吐给客户端前识别限额、封禁、全局容量不足,然后静默换号重试。
- 能在 WebSocket 消息里识别限额和封禁信号。
- 能按 session 做 sticky routing,尽量保住 prompt cache。
- 能给不同账号隔离
prompt_cache_key,避免跨账号缓存污染。 - 能把 ChatGPT 订阅账号、OpenAI Key、第三方 Relay、远程账号池放在同一套切换逻辑里。
- 能记录 5 小时/周周期、每次切号、每个 session 的 token 和成本。
flowchart LR
  A["Codex CLI / IDE"] --> B["Codex Switcher local proxy"]
  B --> C{"Current account usable?"}
  C -->|Yes| D["Forward request"]
  C -->|No: quota / ban / 401 / capacity| E["Pick next healthy account"]
  E --> F["Rewrite token / model / cache key"]
  F --> G["Replay request"]
  D --> H{"Upstream type"}
  G --> H
  H -->|ChatGPT OAuth| I["OpenAI Codex backend"]
  H -->|Relay responses| J["OpenAI-compatible / Relay"]
  H -->|Relay chat_completions| K["GLM / MiMo Coding Plan"]
  K --> L["Translate chat_completions stream back to Codex responses events"]
  I --> M["Client receives one continuous response"]
  J --> M
  L --> M
如果你有 GLM Coding Plan,可以把它接进 Codex Switcher 当 Relay 后端,再配合另一个项目 glance 使用。
glance 是一个 MCP server,用便宜的子模型处理“读一堆文件再总结”“搜索 GitHub 仓库”“抓网页正文”“OCR/描述图片”“Chrome 自动化”等低难度重活。主 Codex 继续负责架构判断和最终代码修改,GLM Coding Plan 负责消耗大的苦活。
推荐分工:
- Codex Switcher:负责 GLM Coding Plan 接入、协议转换、自动切号、重试和配额可视化。
- glance:负责把跨文件阅读、repo 调研、网页抓取、图片理解这类 token-heavy 工作下放给 GLM/DeepSeek/OpenAI 子模型。
- Codex CLI:拿到压缩后的结论,少读原始大文件,把主模型窗口留给真正需要推理和修改的部分。
这个组合适合长期开发:Codex Switcher 保证请求不中断,glance 让低难度高 token 的任务走 Coding Plan,用更低成本把任务量堆起来。
Codex Switcher 内置一个 OpenAI 兼容的 chat/completions 入站端点:把请求翻译成 Codex 的 responses 协议、用你某个 Pro 账号 打 ChatGPT 上游,再把 SSE 组装回标准 chat 响应。这样任何 OpenAI 兼容客户端(glance、hermes 等)都能直接复用 ChatGPT 订阅里的 codex 模型——尤其是编码场景几乎用不上、纯属闲置的 gpt-5.3-codex-spark 额度。
- 端点:
POST http://<host>:18080/v1/chat/completions(本机用localhost:18080;局域网其它机器指向本机内网 IP)。 - 接法:客户端
base_url指向上面、model设gpt-5.3-codex-spark,api_key随便填(桥接用账号自身 token,忽略传入 key)。 - 工具调用:完整支持 function calling 多轮往返(chat
tool_calls⇄ responsesfunction_call/function_call_output),glance sub-agent、hermes agent loop 都能透明使用。 - 视觉自动切换:Spark 不支持图片;请求带图时桥接自动改用可配置的视觉模型,默认使用
gpt-5.6-luna,纯文本仍走 Spark 的独立免费桶。 - 省额度:文本 → Spark(独立闲置桶,不碰主 5h/周);视觉 → Luna Reserve(可用时不切号)。
例:glance 后端
base_url=http://localhost:18080/v1、model=gpt-5.3-codex-spark;hermes 在config.yaml用provider: custom+ 同样的 base_url/model。多客户端共用同一个 Pro 账号的 Spark 桶,账号列表的 Spark 限额可用来盯用量。
- 主动重置次数徽章
🔄 N:来自wham/usage的rate_limit_reset_credits.available_count(手动重置限额的剩余次数)。N>0起可点击直接发起重置,详见下方「主动重置限额」。 - Spark 独立限额:Pro 账号额外显示
Spark 5H / Spark 周(解析additional_rate_limits的 GPT-5.3-Codex-Spark 窗口)。 - 软件内 Codex 邀请:付费号一键发 referral 邀请邮件,弹窗展示邀请链接(解码出奖励 = 主动重置次数)与失败原因;free 号无邀请权限,入口自动隐藏。
- 🚀 启动 codex(鼠标悬停显示):用某账号在隔离
CODEX_HOME+ 直连 OpenAI 下开一个真 codex 终端(referral 兑现需要真 codex CLI 的一次 turn)。
以前 🔄 N 徽章只能看剩余重置次数,没法在软件里发起。现在徽章在 N>0 时可点击,直接消耗 1 次把已耗尽的限额窗口立刻清零 —— 走的是和官方 codex CLI 完全相同的端点(POST chatgpt.com/backend-api/wham/rate-limit-reset-credits/consume),用账号自身 token、与查配额同一条出口发出。
怎么用:
- 在账号面板找一个付费号(Pro / Plus / Team),账号名旁边有
🔄 N徽章且N>0(鼠标移上去变手型)。 - 点一下徽章 → 弹出确认框「将消耗 1 次主动重置次数,把当前已耗尽的 5H / 周限额窗口立刻清零」。
- 点 立即重置 → 底部 toast 显示结果,成功后该号配额会自动重拉刷新(限额条回满、
🔄 N减 1)。
toast 结果对照:
| 提示 | 含义 |
|---|---|
已重置 N 个限额窗口 |
✅ 成功,已消耗 1 次,N 个已耗尽窗口被清零 |
当前没有可重置的限额 |
该号还没撞到上限,不会扣次数 |
没有可用的主动重置次数了 |
剩余次数其实是 0 |
该重置请求已经兑现过了 |
幂等键已用过(正常不会出现,每次点击都新生成 UUID) |
token 失效 / 需要验证 / 请求过于频繁 |
对应上游 401 / 403 / 429 |
⚠️ 每次成功都会真实消耗 1 次,不可撤销;只在该号确实已被限额(限额条接近 0% 或已 429)时点才有意义。free 号没有重置次数,徽章不出现。
周期保鲜用于主动启动并延续 ChatGPT 订阅账号的额度滚动窗口。它会在合适的时间使用目标账号向 Codex Responses 接口发送一次极小请求,让新的额度周期开始倒计时;不需要逐个账号手工开启,所有 ChatGPT OAuth 订阅号默认自动管理,也可以从账号行的 🌿 周期保鲜 按钮单独关闭。
周期保鲜不按 Plus、Pro、Team 等套餐名称写死窗口类型,而是读取 /backend-api/wham/usage 当前返回的 primary_window.limit_window_seconds:
18000秒会显示并管理为5H。604800秒会显示并管理为7D。- OpenAI 将来调整某个套餐的窗口政策时,只要接口返回的新时长正确,就会自动按实际窗口处理。
- 旧缓存没有
limit_window_seconds时,才回退使用接口提供的5H、7D或“周限额”标签判断。
| 场景 | 行为 |
|---|---|
首次接管一个显示 100% 的窗口 |
生成一个唯一启动事件并发送一次极小请求。小请求可能因百分比取整后仍显示 100%,是否成功以周期保鲜记录为准。 |
窗口已经低于 100% |
说明已有真实使用,不额外补发请求。 |
当前时间跨过已记录的 reset_at |
为新的周期生成一个事件并发送一次请求,随后重新读取 usage,保存新的倒计时。 |
| 5H / 7D 同时形成同一个启动事件 | 只发送一次,不重复调用。 |
周期保鲜采用“宁可漏发一次,也不重复烧 Token”的门禁:
- 每个首次启动事件或旧窗口
reset_at都是唯一事件。 - 真实请求发出前,先把事件防重水位持久化到账号数据;保存失败时不会发送。
- 同一事件无论成功、401、403、429、5xx、断网或超时,都不会自动重试第二次。
- client / solo 模式只由 Server 权威端发送,本机客户端只同步状态,避免双 Mac 各发一次。
- 旧客户端推送账号数据时,Server 的已尝试水位只能向前合并,不能被旧状态覆盖。
按钮显示 🌿 周期保鲜 · 5H 或 🌿 周期保鲜 · 7D 代表系统正在自动管理。弹窗内可以查看最近尝试、最近成功和错误;关闭后显示 🌿 保鲜已关。内部保存的 last_attempt_at、last_success_at、last_error 与防重事件 ID 才是执行结果依据,不能仅凭界面百分比是否从 100% 变为 99% 判断。
- 支持 ChatGPT OAuth 账号、OpenAI API Key 账号、第三方 Relay/API Key 账号。
- 一键切换当前账号,写入 Codex CLI 使用的
~/.codex/auth.json。 - 支持导入、导出、批量导入账号数据。
- 支持 OAuth 登录、OTP 邮箱批量登录、Token 自动刷新。
- 支持账号禁用、Token 失效、隔离状态识别,并提供修复入口。
- 支持系统托盘快速切换和后台运行。
Codex Switcher 可以启动本地 HTTP/WebSocket 代理,让 Codex CLI 或其他客户端统一走本地端口。代理层会观察请求、SSE 流和错误信息,并在合适时机自动切换账号。
- 支持 HTTP 和 WebSocket 转发。
- 识别 5 小时配额、周配额、全局容量、账号封禁、401 等常见状态。
- 支持低配额阈值提前切号,减少请求失败。
- 支持无损切号:代理层自动换号并重发请求,前端软件不需要感知账号变化。
- 支持静默刷新 Token,降低 Codex CLI 掉登录概率。
- 支持 LAN 访问,可用于局域网或 ZeroTier 环境。
- 支持 session affinity,把同一个 Codex session 尽量绑定到同一账号,保留上下文缓存收益。
- 支持 SSE bootstrap 检测,在错误流真正转给客户端前完成换号和重试。
- 支持流中 2KB 滑动窗口检测限额/封禁信号。
- 支持 30 秒 SSE keep-alive heartbeat,降低长请求空闲断连。
- 支持 WebSocket 双向桥接,并在 WS 消息中识别限额和封禁。
- 支持自动清理已耗尽账号的 session 绑定,让后续请求可重新路由。
- 支持 moderation sample 抓取,便于分析被安全策略拦截的响应。
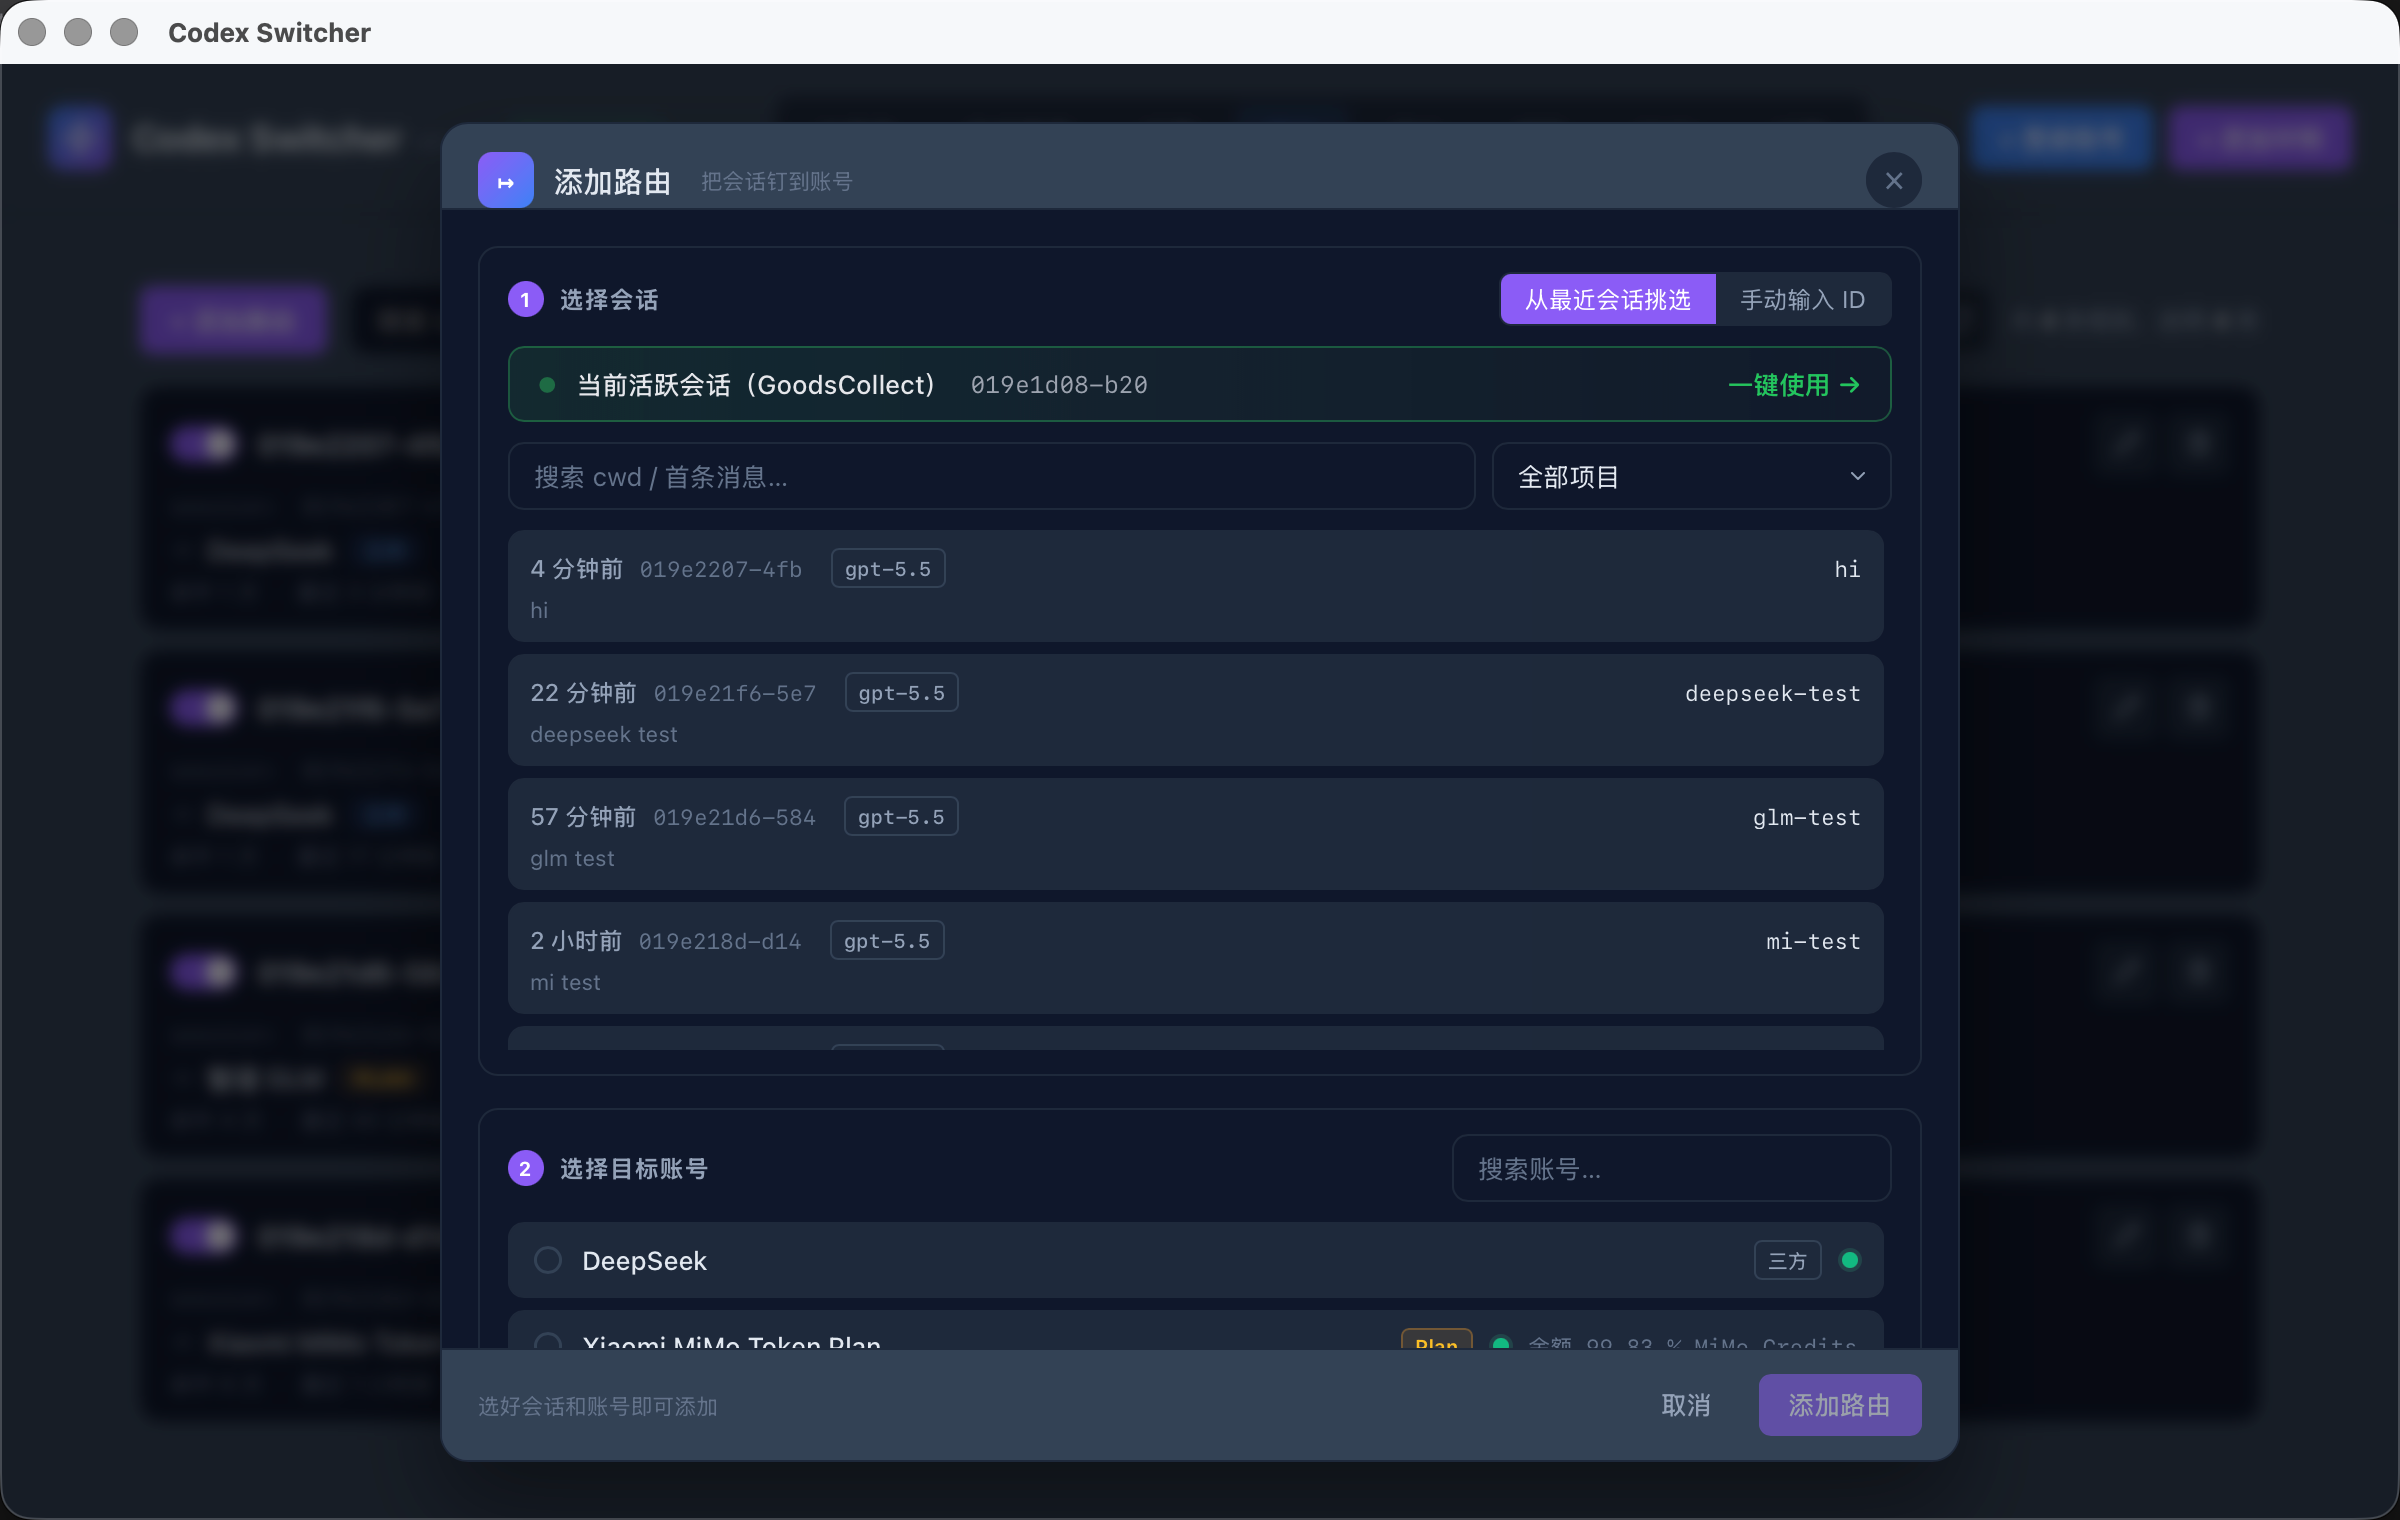
v0.6.0 新增。把"某一条 Codex 对话"硬绑到指定账号,绑完立刻生效,不需要重启 codex、不需要重启 Codex Switcher。适合"这个任务用 GLM Coding Plan,这个任务跑 MiMo,剩下都跑 ChatGPT"这种混合工作流。
Codex CLI / Codex Desktop 默认对所有对话用同一个"当前账号"。Codex Switcher 原本提供了两层选号机制:
store.current—— 全局当前账号,所有请求都走这个。session_affinity—— 软记忆:基于"上游 cached_tokens>0"的命中信号自动把同一个 session 粘到同一账号上,1 小时 TTL,自动失效。
但这两层都不够用:
- 你想让某个特定任务"无论 5h 配额还剩多少、无论自动切号怎么决策,都必须走 GLM/MiMo/DeepSeek"。
- 你想用 ChatGPT 跑主力工作,同时拿 GLM Coding Plan 跑批量低难度任务来省 5h 配额。
- 你想验证某个第三方 Relay 是不是真的接通了,但不想动
store.current,怕影响其他正在跑的对话。
会话路由就是这个第三层 —— 用户主动声明 "session X 永远走账号 Y",无 TTL,强制覆盖前两层,并且对账号被标 banned/logged_out 也照样把流量送过去(让上游返回真实的 401/403,方便你判断是不是该号需要重新登录),不会触发自动切号。
Codex Desktop 0.130+ 用的是 WebSocket 长连接:每个对话开始时跟 Codex Switcher 升级一次 WS,之后整条 WS 持续到对话结束。代理的 hard route 检查只在 WS upgrade 那一刻跑一次:
- 如果你先开始对话、再去 UI 绑定路由,绑定的时候 WS 已经升级到 ChatGPT 了,路由进了内存但旧 WS 不会主动切上游 —— 新消息还是去 ChatGPT。
- 用户视角:路由表上明明写了绑定,UI 显示"启用中",但 codex 那边
命中 0 次,完全像"路由不工作"。
v0.6.0 的修法是:add_session_route / delete_session_route / toggle_session_route 三个 Tauri 命令在写完盘后调用 ws_disconnect.notify_waiters(),所有正在桥接的 WS(无论是 ChatGPT 路径还是 chat_completions Relay 路径)都通过 tokio::select! 收到通知 → 主动关闭 client 侧 → codex 客户端自动重连 → 新 WS upgrade 重新经过 hard route 检查 → 命中新路由。实测从点保存到下一条消息走到新上游约 5 ~ 7 秒,用户无感。
绿色 banner 是 v0.6.0 配套的 UX 优化:打开"添加路由"对话框时,Codex Switcher 后台扫一遍 ~/.codex/sessions/YYYY/MM/DD/rollout-*.jsonl,把 5 分钟内被写过的最新一份的 session_id 提出来 ——那个就是你当前正在跟 codex 聊的会话。点一下 banner 就把 session_id 填到表单里,免去手动复制粘贴。
整条体验:在 codex 里随便发一句 "hi"(让 session 变 active)→ 在 Codex Switcher 点"添加路由"→ 看到绿 banner 显示当前 cwd + session_id → 点 banner → 选目标账号 → 保存 → 下一条消息就到了新上游。不复制 ID、不关 codex tab、不重启 codex-switcher。
- 路由表持久化到
~/.codex-switcher/session_routes.json,UUID 主键,按 session_id 去重 upsert(重新绑同一 session 不丢 hit_count)。 - session_id 来源优先级:codex 请求 header
session_id/thread_id(codex 0.130+ 用下划线版本)> body 里的prompt_cache_key/previous_response_id> model + input hash 兜底。 - 命中后调用
record_hit累加hit_count和last_hit_at,UI 列表可以直接看哪条路由有流量、哪条空跑。 - 路由"严格模式":绑定账号 banned/logged_out/token_invalid 时不切号回 current,让上游真的返回 401/403,避免用户以为"路由静默失败 fallback 了"。
- 同时支持
responses协议(ChatGPT / aggregator Relay)和chat_completions协议(GLM / MiMo / DeepSeek 等 Coding Plan / 三方 API)两条 WS 适配器路径。
Codex.app 26.513.20950 起加了"手机远程连接":手机端 Codex 通过 chatgpt.com/backend-api/codex/remote/control/* 跟桌面端 Codex.app 建 WS bridge,手机可以在桌面 Mac 上发起远程 codex 任务、查看会话状态。bridge 鉴权强校验 auth.json.tokens.id_token 里 https://api.openai.com/auth.chatgpt_account_id 这个 claim —— Codex Switcher 每次切号会重写 disk 上的 auth.json,导致 bridge 立刻断开手机端"离线"。
手机锚解决这个:把账号行末尾的 📱 按钮点亮,整个账号库强约束最多一个 anchor。
| 状态 | 行为 |
|---|---|
| 没设 anchor | 旧行为,切号正常写 disk。 |
| anchor = current | disk 跟随 current,跟旧行为完全一致;不影响任何其他流程。 |
| anchor ≠ current(关键场景) | disk 锁定在 anchor 的 tokens 不变;proxy 出口照切到 current 的号;手机端 Codex.app 仍以 anchor 身份在线,bridge 不掉线;你的 codex CLI 实际用 current 的额度跑请求。 |
后台保活:4 min 独立 tick 用 anchor 的 refresh_token 调 https://auth.openai.com/oauth/token 滚 access_token + 原子落盘,Codex Switcher 是 rt 的唯一写者(disk 上 expires_at 撒谎成 +24h 让 Codex.app 和 codex CLI 都不主动 refresh)。
退出兜底:RunEvent::Exit 和 panic::set_hook 都挂了 disk 修复 —— 退出时把磁盘上 expires_at 替换成 access_token JWT exp 解出的真实值(实测 OpenAI 给的 access_token 寿命 ~240h / 10 天),让 Codex.app 在 Codex Switcher 死掉之后能自己 refresh 一次(代价是 rt 旋转一次,下次启动需要重新登录 anchor —— 用户明确同意的权衡)。
只允许 ChatGPT 订阅号当 anchor:Relay / OpenAI API key 没有 chatgpt_account_id claim,设了 bridge enroll 立刻失败。前端只在订阅号渲染 📱 按钮,后端 set_session_anchor 命令也做强校验拒绝非 OAuth 账号。
跨机器不同步:每台 Mac 上的 Codex.app 用各自的 macOS Secure Enclave 设备私钥(hardware_secure_enclave,非可导出)注册成独立"环境",跨机器复制密钥句柄无意义。所以 is_session_anchor 字段每台机器各自维护,跟 relay_protocol / relay_api_key 不同步同一个原则。
Relay 账号涵盖三类业务形态,分别用独立的 badge 和过滤胶囊管理:
- 中转 (aggregator) —— PinCC / PackyCode / AICodeMirror / Unity2 / FreeModel / 自建 CLIProxyAPI 等基于 new-api / sub2api / CLIProxyAPI 的聚合 reseller,对外暴露
/v1/responses,零翻译透传。 - Coding Plan —— 厂商自家订阅:GLM Coding Plan、Xiaomi MiMo Token Plan、火山方舟 Coding Plan、UCloud Modelverse Coding Plan。
- 三方 (third-party API) —— 厂商按量付费 API:DeepSeek、Moonshot Kimi、MiniMax、通义千问 (DashScope)、腾讯混元、百度千帆、Fireworks AI、阶跃星辰 Stepfun、OpenRouter,以及智谱 GLM 普通端点。
顶部 + 添加中转 按钮(紫)独立于 + 登录账号(蓝)。点开后:
- 选预设卡片 —— 按上面三类分组展示 17 个内置 preset + 自定义条目。每张卡显示 logo / 协议(
/v1/responsesvs/chat/completions)/ 是否订阅。 - 填凭据 —— base URL 已自动填好,只需粘 API Key。高级设置(模型映射表 / 兜底 / MiMo cookie)默认折叠。
- 支持把 Codex
/v1/responses请求转换成/chat/completions,兼容只支持 Chat Completions 的服务(GLM Coding Plan、MiMo、DeepSeek、各厂商直连)。 - 支持流式 SSE 和非流式 sync 双向转换。
- 支持合成
/v1/models响应,便于客户端探测模型。 - 支持模型名映射 + fallback:
gpt-* / o1* → glm-* / mimo-* / deepseek-* / ...。 - 支持
reasoning_content到 Codex reasoning item 的流式转换(DeepSeek-reasoner / GLM-5.1 / MiMo 都已通)。 - 模型重写函数幂等:避免被多次调用时把
o1 → deepseek-reasoner错误回落成 fallback 的deepseek-chat。 - 上游 400 错误(GLM
1261 Prompt exceeds max length等)被归一化为context_length_exceeded,codex CLI 据此自动触发 compact。 - 会丢弃上游不支持的私有 tool 类型,减少 provider 拒绝请求的概率。
- 支持通过 deep link 导入 Relay 配置:
codexswitch://.../ccswitch://...。
- 「自动探测」是新中转账号的默认策略:依次试
/v1/dashboard/billing/subscription(new-api 风格,覆盖 PinCC / PackyCode / AICodeMirror / 自建 new-api)→/v1/usage(sub2api / OpenAI 兼容)→ 都不命中则不拉余额。探测结果会落库,后续刷新走对应 fetcher。 - GLM / MiMo / 智谱 自家的 quota 接口有专门的 fetcher。
- MiMo 配额查询需要 platform.xiaomimimo.com 的 Cookie,UI 表单里有专门的 Cookie 输入区。
两个独立开关控制 Relay 类账号在自动切号链里的行为(设置页可调):
- 「中转 / Plan / 三方 出问题时切回订阅号」(默认开启)—— current 是中转/Plan/三方 时,遇到 401/429/quota 自动切到健康的订阅号。
- 「自动选号可挑中 中转 / Plan / 三方」(默认关闭)—— 用订阅号时,自动切号不会路由到中转/Plan/三方,避免偷扣额度。开启后参与轮询。
所有自动切号路径(preemptive switch、quota 切号重试、SSE 内 rate_limit 切号、silent_refresh 失败后切号、try_local_fallback、收尾兜底 restore)都尊重这两个开关。
Codex CLI 发出的主协议是 /v1/responses。很多 OpenAI-compatible 服务只实现了 /chat/completions,直接接会失败或丢失工具调用、reasoning、流式事件。Codex Switcher 的 Relay 翻译层会处理这些差异:
- 请求侧:把
input、reasoning item、tool call、function output 转成 Chat Completions messages/tools。 - 响应侧:把 Chat Completions 的 stream delta 还原成 Codex 能理解的 Responses SSE 事件。
- 模型侧:把 Codex 请求里的模型名映射成 GLM 可用模型,例如通过 preset 映射到
glm-5.1/glm-5。 - 用量侧:支持 GLM quota API,能在 UI 里显示 relay 的剩余额度和百分比。
这意味着上游不需要完整复刻 Codex Responses API,也能被 Codex CLI 当作可用后端。
Xiaomi MiMo 文档说明 MiMo 模型暂不适配 Responses API,只适用于 Chat Completions API。Codex Switcher 内置 Xiaomi MiMo Token Plan preset,走同一套 Relay 翻译层:
- Base URL:
https://token-plan-sgp.xiaomimimo.com/v1 - API Key:Token Plan 的
tp-...key - 上游协议:
chat_completions - 默认模型:
mimo-v2.5-pro - 模型映射:Codex 常见
gpt-*/o1*请求默认映射到mimo-v2.5-pro - 余额查询:暂不拉取,等 MiMo 暴露稳定 quota/usage API 后再接入
Stats 页面用于长期观察账号池状态和使用成本。
- 展示每个账号的 5 小时配额、周配额、reset 时间、plan 类型。
- 记录每次请求的 input/output/cached input tokens。
- 支持按日、周、月查看 token 使用和估算成本。
- 支持按模型拆分使用量。
- 记录切号历史和切号原因。
- 支持按账号查看 5 小时周期、周周期历史。
- 支持按 session 下钻,分析单个会话消耗。
- 基于 quota snapshot 估算账号真实周期容量。
- 展示 prompt cache 命中和 cached input tokens。
- 估算 cache 节省的成本。
- 统计切号原因分布,便于判断是 5 小时限额、周限额、封禁、Token 失效还是全局容量。
- 通过 quota snapshot 对比不同周期,观察订阅额度是否被 OpenAI 调整。
远程模式适合多台机器共享同一个账号池,例如主力 Mac、Mini Mac、Windows 运行机之间同步使用。
off:完全本地模式。server:当前机器提供远程账号池 API。client:当前机器连接远程 server,同步账号、Token 和切号结果。solo:单客户端模式,自动和远程当前账号保持一致。
远程 API 使用 shared secret 鉴权,支持健康检查、账号列表、Token 获取、账号增删改、远程切号、solo heartbeat、Skills 同步等能力。
远程模式里有两个细节:
- client 会缓存远程 Token,远程不可用时可以回退本地账号。
- solo heartbeat 会告诉 server 跳过本机刷新,减少多设备同时刷新同一个 refresh token 导致的轮转冲突。
Codex Switcher 内置 Skills 管理页面,用于把一组可复用 Agent 能力安装到 Codex、Claude、Gemini、OpenCode 等工具的约定目录。
- 支持从 GitHub 仓库或本地目录添加 Skills 源。
- 支持浏览、安装、卸载 Skills。
- 支持用 SSOT 目录统一管理,再通过 symlink 分发到不同应用。
- 支持从远程 server 同步 Skills。
- 支持切换账号后自动重载或重启相关工具。
- 支持 Windsurf、Antigravity、Cursor、VS Code、Codex CLI 等常见入口。
- 支持 macOS 首次运行时的 quarantine 修复入口。
- 支持暗色界面和系统托盘后台运行。
| 类别 | 能力 |
|---|---|
| 账号 | ChatGPT OAuth、OpenAI Key、Relay/API Key、批量导入导出、OTP 批量登录 |
| 代理 | HTTP、WebSocket、SSE 检测、keep-alive、LAN/ZeroTier、本地端口代理 |
| 自动切号 | 无损切号、自动重发请求、前端无感知、5h/周阈值、Credits 余额兜底、限额识别、封禁识别、401 静默刷新、全局容量处理 |
| Relay | /v1/responses 转 /chat/completions、模型映射、fallback、provider preset、用量查询 |
| GLM | GLM preset、GLM Coding Plan、GLM quota、reasoning_content 流式转换 |
| MiMo | Xiaomi MiMo Token Plan、新加坡 Token Plan 端点、tp-key、Chat Completions 协议转换 |
| 组合 | 搭配 glance,把读文件、搜 repo、网页、图片等低难度苦活交给 GLM Coding Plan |
| 缓存 | session affinity、prompt_cache_key 账号隔离、cache savings 统计 |
| 统计 | tokens、成本、模型分布、周期历史、切号原因、quota snapshot |
| 远程 | server/client/solo、shared secret、远程切号、远程 Token、Skills 同步 |
| Skills | GitHub/local repo、发现、安装、卸载、SSOT、跨工具 symlink |
| 集成 | 托盘、IDE 重载、deep link、macOS quarantine 修复 |
应用主界面按长期使用场景拆成 8 个页面:
| 页面 | 用途 |
|---|---|
| Dashboard | 当前账号、配额概览、快速切换、导出、IDE 同步冲突处理 |
| Accounts | 账号列表、plan/Relay 筛选、单账号配额与 Credits 余额、邀请活动、keepalive、批量刷新 |
| Proxy | 本地代理状态、端口、LAN 暴露、请求/切号计数、自动切号策略 |
| 路由 (v0.6.0) | 会话级硬路由:把指定 codex session 钉到指定账号;一键绑定"当前活跃会话";保存即生效,无需重启 codex |
| Stats | token、成本、模型分布、周期历史、切号原因、容量估算 |
| Cache | session 绑定、cached input tokens、cache savings、请求历史 |
| Skills | 已安装 Skills、远程发现、仓库管理、跨工具 symlink |
| Settings | 主题、后台刷新、IDE 重载、远程模式、macOS quarantine 修复 |
系统托盘提供轻量弹窗,不打开主窗口也能看到当前账号配额、代理状态、token 统计和推荐下一个账号。
添加账号弹窗不是单一路径,适合把历史账号池快速迁进来:
- OpenAI OAuth:浏览器授权,自动交换 token;回调失败时支持手动粘贴 fallback。
- 从 IDE 导入:自动检测本机 Codex/Windsurf 等工具的
auth.json。 - OTP 批量登录:粘贴邮箱列表,自动跑 OTP 流程,显示每行进度并支持失败重试。
- 批量文件导入:支持多种历史格式,自动识别并按邮箱去重。
- Relay 导入:手动填写或通过
codexswitch:///ccswitch://deep link 一键导入。
| 类型 | 业务分类 | 状态 |
|---|---|---|
| ChatGPT OAuth (PRO/PLUS/TEAM/FREE) | 订阅 | ✅ 配额读取、token 刷新、无损切号、周期统计 |
| OpenAI API Key | 三方 | ✅ 作为账号类型纳入管理 |
| 通用 Responses 中转 (new-api / sub2api / CLIProxyAPI) | 中转 | ✅ 透传 /v1/responses,余额自动探测 |
| GLM Coding Plan | Coding Plan | ✅ Chat Completions 翻译 + GLM quota |
| 智谱 GLM(普通 paas/v4) | 三方 | ✅ Responses 直连 |
| Xiaomi MiMo Token Plan | Coding Plan | ✅ 端到端验证:多轮(5+ 轮)连续对话、thinking 模式、Token Plan 配额 1 天 8 时 40 单 100%;reasoning_content 强校验已通过历史修剪 workaround 闭环 |
| DeepSeek | 三方 | ✅ 端到端验证:单轮 / 多轮 tool_call / deepseek-reasoner 流式 reasoning 全过 |
| Moonshot Kimi | 三方 | |
| MiniMax | 三方 | |
| 通义千问 (DashScope) | 三方 | |
| 火山方舟 (Doubao) | Coding Plan | |
| 腾讯混元 | 三方 | |
| 百度千帆 (ERNIE) | 三方 | |
| UCloud Modelverse | Coding Plan | |
| Fireworks AI | 三方 | |
| 阶跃星辰 Stepfun | 三方 | |
| OpenRouter | 三方 | |
| Codex CLI | — | ✅ 主要目标客户端 |
| Windsurf / Cursor / VS Code / Antigravity | — | ✅ 支持账号切换后的 IDE 重载/同步工作流 |
| macOS / Windows / Linux | — | GitHub Release 多平台构建 |
未端到端验证的 11 个三方/Coding Plan 预设是按各家公开文档填的 base URL + model_fallback。基础形态都对,但每家厂商对 reasoning_content / tool_calls 历史 / 特殊字段的强校验各不相同(MiMo 撞到的 char-0 / context_length 错误是典型)。冒烟测试时撞到 quirk 请提 issue,会按 case-by-case 在 relay_translate.rs 里加分支。
以下能力是在 relay_translate.rs / proxy.rs 的 provider-无关 路径里实现的,所有走 chat_completions 翻译的 Relay 上游都自动生效,包括未端到端测试过的那些。但能不能"用得好"还要看模型本身的能力——这里只保证协议层不再卡:
- namespace 工具递归展开:codex 把 MCP / 分组工具打包进
type=namespace,旧版本直接 drop 整组。现在递归 flatten 出来发给上游,模型能调到 MCP 工具。 local_shell→ 标准shellfunction:codex builtin 工具映射成带完整 schema 的 OpenAI function tool。customfreeform 工具 → input:string function:codex 的apply_patch等 grammar-constrained 工具映射成input: string的普通 function(grammar 约束丢失,模型输出格式能不能 apply 看模型训练,但至少能"调"了)。encrypted_content双向 round-trip:reasoning item 输出时塞encrypted_content字段,codex 下轮回传时还原回 chat messages 的reasoning_content。MiMo thinking 模式强校验靠它过;其它 reasoning 模型(DeepSeek-reasoner / GLM-5.1 思维链 / 火山 doubao-thinking 等)保留推理上下文也受益。- chat_completions 上游 header 白名单:codex 私有
x-codex-*/OpenAI-Beta/session_id等不再转发给第三方上游 —— 防止边缘 WAF 误把 POST 路由到 WebSocket handler 返 405(GLM 撞到过)。
注:上述协议层改进不等于端到端验证。即使翻译层不再卡,模型本身能不能稳定调 shell/apply_patch、能不能跑长会话、能不能正确 stream reasoning_content,还得看 provider 自家实现。
内置的 Coding Plan / 三方 API / 中转 provider 全表。所有走 chat_completions 协议的 provider 都通过 relay_translate.rs 把 Codex /v1/responses 翻译成各家 /chat/completions;通用 Responses 中转直接透传不翻译。
| Provider | base_url | 类别 | 协议 | 备注 |
|---|---|---|---|---|
| 通用 Responses 中转 | 用户填 | 中转 | responses | 适配 new-api / sub2api / CLIProxyAPI 系所有中转 |
| 智谱 GLM(普通) | open.bigmodel.cn/api/paas/v4 |
三方 | chat_completions | |
| 智谱 GLM Coding Plan | open.bigmodel.cn/api/coding/paas/v4 |
Coding Plan | chat_completions | 已端到端验证 |
| DeepSeek | api.deepseek.com/v1 |
三方 | chat_completions | 已端到端验证(v4-pro / v4-flash) |
| Moonshot Kimi | api.moonshot.cn/v1 |
三方 | chat_completions | |
| MiniMax | api.minimax.chat/v1 |
三方 | chat_completions | |
| Xiaomi MiMo Token Plan | token-plan-sgp.xiaomimimo.com/v1 |
Coding Plan | chat_completions | tp-key,reasoning_content 历史已加修剪 workaround |
| Xiaomi MiMo 按量付费 | api.xiaomimimo.com/v1 |
三方 | chat_completions | sk-key,跟 Token Plan 区分 |
| 阿里 DashScope(通义千问) | dashscope.aliyuncs.com/compatible-mode/v1 |
三方 | chat_completions | |
| 火山方舟 (ByteDance Doubao) | ark.cn-beijing.volces.com/api/v3 |
Coding Plan | chat_completions | model 字段需填 endpoint id |
| 腾讯混元 | api.hunyuan.cloud.tencent.com/v1 |
三方 | chat_completions | |
| 百度千帆 (ERNIE) | qianfan.baidubce.com/v2 |
三方 | chat_completions | |
| UCloud Modelverse | deepseek.uk-tokyo.ucloud-global.com/v1 |
Coding Plan | chat_completions | 多模型聚合,海外区 |
| Fireworks AI | api.fireworks.ai/inference/v1 |
三方 | chat_completions | 海外按量 / Fire Pass 订阅 |
| 阶跃星辰 StepFun Step Plan | api.stepfun.com/step_plan/v1 |
Coding Plan | chat_completions | 直接读取原生 step-* 模型;Oasis-Token 查询 Credit 额度 |
| 阶跃星辰 OpenAPI | api.stepfun.com/v1 |
三方 | chat_completions | 普通按量 API,与 Step Plan 分开 |
| OpenRouter | openrouter.ai/api/v1 |
三方 | chat_completions | 500+ 模型聚合 |
| 魔搭 ModelScope | api-inference.modelscope.cn/v1 |
三方 | chat_completions | Qwen 系列为主 |
| Ollama 本地推理 | localhost:11434/v1 |
三方 | chat_completions | 本地推理,API Key 可填任意非空字符串 |
| Aiberm | aiberm.com/v1 |
三方 | chat_completions | OpenAI/Anthropic 双协议聚合,我们走 OpenAI 路径 |
| 神马中转 (Whatai) | api.whatai.cc/v1 |
三方 | chat_completions | OpenAI/Anthropic 双协议聚合,我们走 OpenAI 路径 |
| 自定义 | 用户填 | — | 用户选 | 手动填 base_url,自选 usage 策略 |
协议层目前未覆盖:纯 Anthropic Messages API(如 Anthropic 官方、Kiro IDE 中转)—— Codex 不讲 Anthropic 协议,要接入需要另写一套 /v1/responses ↔ Anthropic /v1/messages 翻译层(≈ Moon Bridge 工作量),暂未排上。
- 打开应用。
- 添加或导入多个 ChatGPT OAuth 账号。
- 在账号列表里点击切换。
- Codex Switcher 会更新
~/.codex/auth.json。 - 需要时自动刷新或重载 IDE。
- 在设置里启用本地代理。
- 配置代理端口和切号阈值。
- 让 Codex CLI 或客户端请求走本地代理地址。
- 当当前账号配额不足、触发限额或 Token 失效时,代理会自动刷新或切换账号。
- 对可重试请求,代理会后台重发,前端软件无需知道已经换过账号。
- 添加 Relay 账号。
- 填入
base_url、api_key、模型映射和余额查询预设。 - 对只支持 Chat Completions 的服务,启用协议转换。
- 在代理模式下混用 ChatGPT OAuth 账号和 Relay 账号。
- 添加 Relay 账号时选择 GLM Coding Plan preset。
- 填入 GLM 的 API Key。
- preset 会自动配置 base URL、Chat Completions 协议转换、模型映射和 GLM quota 查询。
- Codex CLI 继续按 Responses API 发请求,Codex Switcher 在代理层完成协议转换。
- 添加 Relay 账号时选择 Xiaomi MiMo Token Plan preset。
- 填入 MiMo Token Plan 的
tp-...API Key。 - preset 会自动配置新加坡 Token Plan base URL、Chat Completions 协议转换和
mimo-v2.5-pro模型映射。 - Codex CLI / Codex App 继续按 Responses API 发请求,Codex Switcher 在代理层转成 MiMo 支持的 Chat Completions。
- 安装 glance 并注册到 Codex MCP。
- 把 glance backend 配到 GLM Coding Plan。
- 让 Codex 把“跨文件调研、GitHub repo 探索、网页抓取、图片 OCR/描述”等任务优先交给 glance。
- Codex Switcher 负责保证 GLM Relay 请求稳定,glance 负责把大段原始材料压缩成短摘要返回给 Codex。
- 在主机器设置为
server,配置 bind、port、shared secret。 - 在其他机器设置为
client或solo。 - 填入 server URL 和 shared secret。
- 客户端从 server 获取账号状态、Token 和切号结果。
Client 可在设置中开启「自动拉取 Server Skills」:启动时及每 5 分钟使用现有 Server 地址、回退地址和共享密钥拉取 /skills/bundle,也可手动立即拉取。此选项默认关闭,需要 Server 和 Client 都支持该接口。
Skills 保存到当前用户的 ~/.codex-switcher/skills,无需配置用户名或固定机器地址。同步副本内引用的 Server Home 路径会适配为 Client Home;Server 原文件不修改。Linux 会排除依赖 macOS 命令、应用或缺失本机项目/Skills 的内容,Homebrew 可执行文件路径按本机 PATH 解析。可在 Skill 根目录添加 compatibility.json 明确声明,例如 {"platforms":["linux","macos"],"requires":["python3","git"]}。声明不能使不兼容命令自动变得兼容;平台检查仍然保守执行。
本机 .system、未受同步管理的 Skills 以及本机修改均保留,不会被远端覆盖。拉取副本不会通过「同步到 Server」回传,避免把 Client 路径反写到 Server。原先受管理的未修改副本在更新或远端移除时备份到 ~/.codex-switcher/skills-pull-backups。网络或旧 Server 接口失败时保留上次副本;状态记录在 skills-pull-report.json。客户端现有 Skills 黑名单也用于拉取排除。导出跳过符号链接、缓存和检测到内嵌凭据的 Skills。
适用:用 Codex.app 26.513+ 桌面端 + 手机版 Codex,希望手机端常驻在线、随时远程发任务到 Mac,但本机还想自由切换其他订阅号 / Coding Plan / Relay 来跑日常编码。
- 在 Codex Switcher 账号列表,找到手机版 Codex 登录的那个 ChatGPT 订阅号(通常是 Pro/Plus)。
- 点这一行末尾的 📱 按钮 —— 该行 name 旁会出现"📱 手机锚"badge,磁盘
~/.codex/auth.json立刻被锁定到这个号。 - 之后正常切号 / 配置会话路由 / 用 GLM Coding Plan:Codex Switcher 会保证 disk 不动,手机端 Codex.app 持续显示在线。Dashboard 顶部会显示蓝紫渐变 banner:"手机锚生效:Codex.app 仍以 X 身份在线,代理出口已切到 Y"。
- 想取消时再点一次 📱(变灰),整个集群回到无 anchor 的旧行为。
- 限制:anchor 只能设在 ChatGPT 订阅号上(OAuth)。Relay / OpenAI API key 没有
chatgpt_account_idclaim,bridge 鉴权用不上。
Linux 从源码构建生产二进制时,请使用 bash scripts/build-linux-production.sh(需已安装构建依赖),或通过 Tauri CLI 构建安装包。直接运行 cargo build --release 不会自动启用 tauri/custom-protocol,可能使窗口仍连接开发地址 localhost:1420,出现连接被拒绝。生产构建必须内嵌 dist 前端资源,不能依赖 Vite 开发服务。
Linux 配置无人登录也运行的用户服务时,可用 scripts/linux-client-service.sh 在桌面显示与 Xvfb 之间选择;桌面启动器和登录自启应通过 scripts/linux-client-open.sh 启动同一个服务,避免后台代理与桌面窗口重复运行。这两个辅助脚本要求 systemd 用户服务、Xvfb 和 xdpyinfo;普通桌面安装不需要配置此服务。
从 Releases 下载最新版本。
当前发布流程会生成:
- macOS:
aarch64.dmg、x64.dmg、universal.dmg - Windows:
x64-setup.exe、x64_en-US.msi - Linux:
.deb、.rpm、.AppImage
macOS 用户通常下载 aarch64.dmg;Intel Mac 下载 x64.dmg;不确定架构时下载 universal.dmg。
Windows 用户优先下载 x64-setup.exe;需要 MSI 部署时下载 x64_en-US.msi。
环境要求:
- Node.js 20+
- Rust stable
- Tauri 2 所需系统依赖
npm install
npm run tauri dev
只运行前端开发服务器:
npm run dev生产构建:
npm run tauri build前端构建检查:
npm run buildRust 检查:
cd src-tauri
cargo checkRelease workflow 在以下情况触发:
- push
v*tag - 手动
workflow_dispatch
构建矩阵:
- macOS
aarch64-apple-darwin - macOS
x86_64-apple-darwin - macOS
universal-apple-darwin - Ubuntu 22.04
- Windows latest
所有平台构建成功后,publish-release job 会把产物上传到对应 GitHub Release。
Codex Switcher 会在本机保存账号、Token、配额缓存、统计数据和日志。使用前请确认你信任当前机器和用户环境。
常见本地数据位置:
- Codex CLI 当前登录态:
~/.codex/auth.json - Codex Switcher 应用数据:
~/.codex-switcher/ - 代理日志:
~/.codex-switcher/proxy.log
注意:
- 不要把
auth.json、账号导出包、Token、API Key、Relay Key 提交到 Git。 - 远程模式必须使用强 shared secret。
- 允许 LAN 代理访问前,先确认局域网环境可信。
- 机器本地启动器和辅助脚本不属于仓库源码,不应提交。
机器本地文件示例:
C:\Users\Administrator\.codex\start-codex-auto-proxy.ps1
C:\Users\Administrator\Desktop\Start Codex Auto Proxy.bat
C:\Users\Administrator\Desktop\Start Codex Auto Proxy.lnk
~/.codex/start-codex-auto-proxy.sh
~/Desktop/Start Codex Auto Proxy.command
仓库只保留可复用的应用代码、文档和构建配置。
- Frontend: React, TypeScript, Vite
- Desktop: Tauri 2
- Backend: Rust, Tokio, Hyper, Reqwest
- UI: CSS, dark theme
- Release: GitHub Actions
MIT License. See LICENSE.
Codex Switcher is a desktop app for multi-account Codex CLI / Codex App workflows. It brings account management, quota visibility, a local proxy, lossless automatic account switching, relay endpoints, Coding Plan integration, remote account pools, and Skills management into one Tauri app. It is designed for people who use Codex CLI, Codex App, and VS Code-derived IDEs with Codex plugin support for long-running development work.
In one line: when the current account hits quota, your frontend task does not need to stop. Codex Switcher can switch accounts, switch relay endpoints, or route through a Coding Plan, then replay the request automatically. Coding Plan support is currently tested with GLM and Xiaomi MiMo Token Plan.
Download the latest release · Use with glance
Important
You can keep Codex Desktop signed in to a Team / Business workspace. Some macOS Codex Desktop builds have an authentication regression where opening a task causes the account-settings request to return 401 and the app to drop the global login; see openai/codex#39162. If personal Plus / Pro login loops but Team / Business keeps the app stable, leave Desktop on Team. A 0% value in the Desktop workspace menu is not the quota of the account currently selected by Codex Switcher.
Before every final HTTP or WebSocket hop, Codex Switcher removes the workspace identity inherited from Desktop and rebuilds Authorization plus chatgpt-account-id from the account actually selected by the proxy. Desktop can therefore use Team as its shell login while proxy traffic uses the selected Plus / Pro / Team / Relay account. Account switches, retries, and remote Server forwarding follow the same rule.
- Phone anchor (v0.7.0): Codex.app 26.513+ ships a phone↔Mac remote-control bridge whose handshake is bound to
auth.json'schatgpt_account_id. Anchoring a ChatGPT subscription account freezes the on-diskauth.jsonto that account while the proxy still routes traffic for whatever account is currently selected — your phone keeps showing the desktop online, your CLI runs on the switched account. A dedicated 4-min refresh tick keeps the anchor's token alive, and an exit/panic hook restores the access-token JWT's realexp(≈240h) so Codex.app can self-refresh if the switcher dies. Subscription accounts only — relay / API key cannot anchor. - Lossless account switching: quota, ban, 401, and global-capacity failures can trigger proxy-level account switching and request replay.
- Desktop workspace isolation: Codex Desktop may stay pinned to Team / Business for app stability, while each proxy request rebuilds the bearer token and
chatgpt-account-idas one identity pair. This prevents stale Team workspace headers from causing false 401s, false quota exhaustion, and switch loops. - GLM Coding Plan support: translates Codex
/v1/responsestraffic into OpenAI/chat/completionsfor GLM Coding Plan. - Xiaomi MiMo Token Plan support: built-in MiMo-V2.5 Token Plan preset with
tp-keys, Singapore endpoint, and Chat Completions translation. - Multi-account pool: manages Codex OAuth accounts, OpenAI API keys, relay/API-key accounts, and remote account pools.
- Quota visibility: tracks 5-hour and weekly quota, token usage, costs, cache savings, switch reasons, and quota cycles.
- Disposable-account expiry reminders: stores a manually managed subscription-expiry date per account, shows it in the account list, and highlights dates within 7 days or already expired. ChatGPT / Codex currently exposes no trustworthy subscription-expiry API, so this value stays separate from OAuth token expiry and quota reset windows and never drives automatic switching.
- Quota-cycle keepalive: enabled by default for every ChatGPT subscription account, with per-account opt-out. Window semantics come from
/wham/usageprimary_window.limit_window_seconds, not hardcoded plan names, so future OpenAI policy changes are handled automatically. The system creates one bootstrap event only for an ambiguous 100% window; a window clearly below 100% receives no extra request. Later, crossing the semantic cachedreset_atcreates the next event. The authoritative host durably reserves each event before one minimal Codex request; events are never retried automatically. - Long-session friendly: session affinity and per-account
prompt_cache_keyisolation help preserve prompt-cache benefits. - Cross-tool Skills: discover, install, sync, and link Skills across Codex, Claude, Gemini, and OpenCode-style directories.
Codex account operations often end up scattered across separate scripts: one for login, one for switching, one for proxying, and another place for quota notes. Codex Switcher keeps those workflows in one desktop app and understands Codex traffic at the proxy layer.
Its key capability is not just replacing auth.json. The important part is lossless switching:
- When the current account hits quota, gets banned, returns 401, or hits global capacity, the proxy can pick another usable account.
- The frontend tool does not need to know an account changed.
- For retryable cases, the proxy switches accounts and replays the request in the background.
/v1/responsestraffic can be translated into/chat/completions, so GLM Coding Plan and Xiaomi MiMo Token Plan can be used even though they do not fully implement the Codex Responses API.- SSE and WebSocket streams are inspected for quota and ban signals before the client is forced to fail.
If you have GLM Coding Plan, you can add it to Codex Switcher as a relay backend and pair it with glance.
glance is an MCP server that offloads token-heavy but lower-difficulty work: reading many files, exploring GitHub repos, fetching web pages, OCR/image description, and browser-assisted extraction. Codex remains responsible for architecture decisions and final code changes, while GLM Coding Plan handles the heavy reading.
Recommended split:
- Codex Switcher handles GLM Coding Plan routing, protocol translation, automatic switching, retries, and quota visibility.
- glance handles large context-gathering tasks and returns compact summaries to Codex.
- Codex CLI spends less context on raw material and more on reasoning and edits.
| Area | Capabilities |
|---|---|
| Accounts | Codex OAuth accounts, OpenAI keys, relay/API-key accounts, import/export, OTP batch login |
| Proxy | HTTP, WebSocket, SSE detection, keep-alive, LAN/ZeroTier access, local proxy port |
| Auto switching | Lossless account switch, automatic replay, quota/ban/401/global-capacity detection |
| Relay | /v1/responses to /chat/completions, model mapping, fallback models, provider presets |
| GLM | GLM preset, GLM Coding Plan, GLM quota query, reasoning_content stream conversion |
| MiMo | Xiaomi MiMo Token Plan, Singapore endpoint, tp- key, mimo-v2.5-pro model mapping |
| Cache | Session affinity, per-account prompt_cache_key, cache-savings statistics |
| Stats | Tokens, costs, model split, quota cycles, switch reasons, quota snapshots |
| Remote | Server/client/solo modes, shared secret, remote token access, remote switching, Skills sync |
| Skills | GitHub/local sources, install/uninstall, SSOT directory, cross-tool symlinks |
Download the latest build from Releases.
- macOS:
aarch64.dmg,x64.dmg, oruniversal.dmg - Windows:
x64-setup.exeorx64_en-US.msi - Linux:
.deb,.rpm, or.AppImage
Requirements:
- Node.js 20+
- Rust stable
- Tauri 2 system dependencies
npm install
npm run tauri dev
Build:
npm run tauri buildCodex Switcher stores accounts, tokens, quota cache, statistics, and logs on your machine. Use it only on machines and user environments you trust.
Common local paths:
- Codex CLI auth state:
~/.codex/auth.json - Codex Switcher data:
~/.codex-switcher/ - Proxy log:
~/.codex-switcher/proxy.log
Do not commit auth.json, account exports, tokens, API keys, or relay keys to Git. Remote mode should always use a strong shared secret.
MIT License. See LICENSE.
Codex Switcher — это настольное приложение для рабочих процессов с несколькими аккаунтами Codex CLI / Codex App. Оно объединяет управление аккаунтами, просмотр квот, локальный прокси, автоматическое переключение аккаунтов без потери запроса, промежуточные relay-сервисы, подключение Coding Plan, удаленные пулы аккаунтов и управление Skills в одном Tauri-приложении. Инструмент рассчитан на пользователей Codex CLI, Codex App и IDE на базе VS Code с поддержкой Codex-плагина.
Коротко: если текущий аккаунт уперся в лимит, задача во фронтенд-инструменте не должна останавливаться. Codex Switcher может автоматически сменить аккаунт, переключить промежуточный сервер или отправить запрос через Coding Plan, а затем повторить запрос. Поддержка Coding Plan сейчас проверена с GLM и Xiaomi MiMo Token Plan.
Скачать последнюю версию · Использовать вместе с glance
Important
Codex Desktop можно оставить авторизованным в Team / Business, если личный Plus / Pro попадает в цикл выхода из системы; см. openai/codex#39162. Показатель 0% в меню Team относится к workspace Desktop, а не обязательно к аккаунту, выбранному в Codex Switcher. Перед HTTP / WebSocket запросом прокси заново связывает Authorization и chatgpt-account-id с одним фактически выбранным аккаунтом.
- Переключение без потери запроса: лимиты, блокировки, 401 и ошибки глобальной емкости могут обрабатываться на уровне прокси с повторной отправкой запроса.
- Изоляция workspace Desktop: Desktop может оставаться в Team / Business, а прокси использует согласованную пару bearer token +
chatgpt-account-idвыбранного аккаунта, не наследуя устаревший Team workspace. - Поддержка GLM Coding Plan: трафик Codex
/v1/responsesпереводится в OpenAI/chat/completions. - Поддержка Xiaomi MiMo Token Plan: встроенный preset для MiMo-V2.5 Token Plan,
tp-key, Singapore endpoint и перевод в Chat Completions. - Пул аккаунтов: Codex OAuth, OpenAI API keys, relay/API-key аккаунты и удаленные пулы.
- Наблюдаемость квот: 5-часовые и недельные квоты, токены, стоимость, cache savings, причины переключений и история циклов.
- Напоминания об окончании подписки: для каждого аккаунта можно вручную указать дату окончания подписки; даты в пределах 7 дней и уже истекшие выделяются в списке. ChatGPT / Codex сейчас не предоставляет надежное API этой даты, поэтому она хранится отдельно от срока OAuth-токена и окон сброса квот и не влияет на автоматическое переключение.
- Поддержание цикла квоты: по умолчанию включено для всех подписочных аккаунтов ChatGPT и может быть отключено отдельно. Тип окна определяется по фактическому
primary_window.limit_window_secondsиз/wham/usage, а не по названию тарифа. Для неоднозначного окна с 100% создается одно стартовое событие; окно ниже 100% не получает лишний запрос. Далее события возникают после перехода через правильныйreset_at. Авторитетный хост сначала сохраняет защитную отметку, затем отправляет один минимальный запрос Codex; событие никогда не повторяется автоматически после ошибки. - Поддержка длинных сессий: session affinity и изоляция
prompt_cache_keyпо аккаунтам помогают сохранить пользу prompt cache. - Skills для разных инструментов: поиск, установка, синхронизация и symlink-распределение Skills для Codex, Claude, Gemini и OpenCode-подобных инструментов.
Операции с аккаунтами Codex часто распадаются на отдельные скрипты: вход, смена аккаунта, прокси, заметки по квотам. Codex Switcher собирает это в одном настольном приложении и понимает поток запросов Codex на уровне прокси.
Главная функция — не просто замена auth.json, а переключение без потери запроса:
- Если аккаунт исчерпал квоту, заблокирован, вернул 401 или попал в global capacity, прокси выбирает другой доступный аккаунт.
- Клиентское приложение не обязано знать, что аккаунт изменился.
- Для повторяемых запросов прокси переключает аккаунт и отправляет запрос заново в фоне.
- Запросы
/v1/responsesмогут быть преобразованы в/chat/completions, что позволяет использовать GLM Coding Plan и Xiaomi MiMo Token Plan без полной реализации Codex Responses API. - SSE и WebSocket потоки проверяются на сигналы лимита и блокировки до того, как клиент увидит ошибку.
Если у вас есть GLM Coding Plan, его можно подключить в Codex Switcher как relay backend и использовать вместе с glance.
glance — это MCP server для тяжелых по токенам, но относительно простых задач: чтение множества файлов, исследование GitHub-репозиториев, загрузка веб-страниц, OCR/описание изображений и browser extraction. Codex остается для архитектурных решений и финальных правок, а GLM Coding Plan берет на себя объемное чтение.
| Область | Возможности |
|---|---|
| Аккаунты | Codex OAuth, OpenAI keys, relay/API-key аккаунты, import/export, OTP batch login |
| Прокси | HTTP, WebSocket, SSE detection, keep-alive, LAN/ZeroTier, локальный порт |
| Автопереключение | Переключение без потери запроса, replay, quota/ban/401/global-capacity detection |
| Relay | /v1/responses to /chat/completions, model mapping, fallback, provider presets |
| GLM | GLM preset, GLM Coding Plan, GLM quota query, преобразование reasoning_content |
| MiMo | Xiaomi MiMo Token Plan, Singapore endpoint, tp- key, model mapping на mimo-v2.5-pro |
| Cache | Session affinity, per-account prompt_cache_key, cache-savings statistics |
| Stats | Tokens, cost, model split, quota cycles, switch reasons, quota snapshots |
| Remote | Server/client/solo, shared secret, remote tokens, remote switching, Skills sync |
| Skills | GitHub/local sources, install/uninstall, SSOT directory, cross-tool symlinks |
Скачайте последнюю сборку в Releases.
- macOS:
aarch64.dmg,x64.dmgилиuniversal.dmg - Windows:
x64-setup.exeилиx64_en-US.msi - Linux:
.deb,.rpmили.AppImage
Требования:
- Node.js 20+
- Rust stable
- системные зависимости Tauri 2
npm install
npm run tauri dev
Сборка:
npm run tauri buildCodex Switcher хранит аккаунты, токены, кэш квот, статистику и логи на вашей машине. Используйте его только в доверенной среде.
Типичные локальные пути:
- состояние Codex CLI:
~/.codex/auth.json - данные Codex Switcher:
~/.codex-switcher/ - лог прокси:
~/.codex-switcher/proxy.log
Не коммитьте auth.json, экспорты аккаунтов, токены, API keys или relay keys в Git. Для удаленного режима используйте сильный shared secret.
MIT License. См. LICENSE.