
2.3 HotSpot虚拟机对象探秘
本章主要内容: HotSpot 虚拟机在Java 堆 中对象分配、布局和访问的全过程。
2.3.1 对象的创建
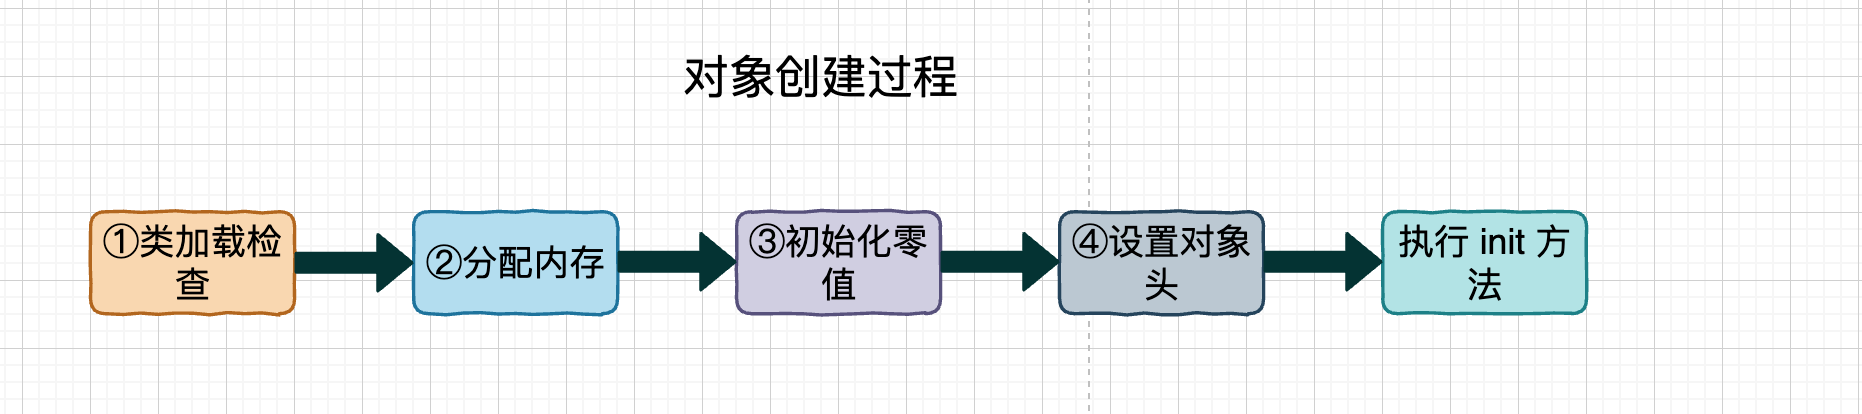
最简单最常用的创建对象的方式:使用 new 操作符。在虚拟机中,以下是虚拟机中普通对象(仅限普通 Java 对象,不包括数组和 Class 类型对象)的创建过程:
当JVM 遇到一条内容是 new 的字节码指令时,**首先检查**这个指令的参数是否能在常量池中定位到一个类的符号引用,并且检查这个符号引用代表的类是否已经被加载、解析和初始化过。
如果没有,则执行「类加载」过程。这个过程在第7章中详细探讨。
当类加载检查通过后,接下来虚拟机为新生对象分配内存。 对象所需的内存大小在类加载完成后就可以完全确定下来,为对象分配空间相当于把一块确定大小的内存块从 Java 堆中划分出来。
假设 Java 堆中的内存是绝对规整的,所有被使用过的内存都放在一边,没有使用的放在另一边,中间存在一个指针作为分界点的指示器,那么分配内存只需要将指向向空闲空间方向挪动一段与对象大小相等的距离即可,这种方式叫做「指针碰撞」(Bump The Pointer)。
但如果 Java 堆中的内存并不是规整的,已被使用的内存和空间内存相互交错,那就没有办法简单地通过指针碰撞完成了,则虚拟机需要维护一个「空闲列表」(Free List)。
选择哪种分配方式由 Java 堆是否规整决定,而 Java 堆是否规整又取决于采用的垃圾收集器是否带有 「空间压缩整理」(Compact)能力决定。
因此,当使用 Serial、ParNew 等带压缩整理过程的收集器时,系统采用的分配方法是「指针碰撞」,既简单又高效;
当使用 CMS 这种基于清除(Sweep)算法的收集器时,理论上就只能采用较为复杂的空闲列表来分配内存。
除了划分可用空间,还需要考虑对象的创建是非常频繁的行为,有可能存在正在给对象A 分配内存,指针还没来得及修改,对象B又同时使用了原来的指针来分配内存的情况,针对这个问题有两种解决方案:
- 对分配内存空间的动作进行同步处理 —— 实际上虚拟机是采用 **
CAS(Compare And Swap)**配上失败重试的方式保证更新操作的原子性【举个例子呢?】
- 把内存分配动作按线程划分在不同的空间之中进行 —— 每个线程在 Java 堆中预先分配一小块内存空间,称为「本地线程缓冲(TLAB)」,哪个线程要分配内存,就在那个线程的本地缓冲区中进行分配,只有本地缓冲区用完了,分配新的缓存区时才需要同步锁定。是否使用TLAB 可以使用参数
XX: +/- UseTLAB 参数设定
内存分配完成之后,虚拟机的下一步工作就是「分配内存空间(不包括对象头)」,初始化零值,如果使用了 TLAB 来创建对象,这一项工作也可以提前到 TLAB 分配时顺便进行。 这一步操作保证了对象的**实例字段在 Java 代码中可以不赋初始值就直接使用,因为虚拟机将这些字段初始化为了它们对应的零值。**
从虚拟机的视角来看,初始化零值之后一个新的对象就已经产生了。但是从Java程序视角来看,对象的创建才刚刚开始——构造函数还没有执行,所有的类实例字段都是默认的零值,对象需要的其他资源和状态信息也没有按照预定的意图构造好。
一般来说,由字节码流中的 new 指令后面是否跟随 invokespecial 指令所决定, Java 编译器会在遇到 new 关键字的地方同时生成这两条字节码指令,但如果直接通过其他方式产生的对象则不一定如此。 new 指令之后会接着执行 <init>()方法,也就是构造函数中的对象初始化的内容,这样一个真正可用的对象才完全被构建完成。
下面的代码清单 2-1 是 HotSpot 虚拟机字节码解释器(bytecodeInterpreter.cpp) 中的代码片段,这个解释器很少有机会实际使用 —— 大部分平台使用的都是模板解释器。
当代码通过**即时编译器**执行时差异就更大了,不过这段代码在用于了解 HotSpot 的运行过程是没有问题的。(作者添加了注释)
     if (!constants->tag_at(index).is_unresolved_klass()) { // 确保常量池中存放的是已解释类
          // 断言确保是 klassOop 和 instanceKlassOop
          Klass* entry = constants->resolved_klass_at(index);
          InstanceKlass* ik = InstanceKlass::cast(entry);
          // 确保对象所属类型已经经过初始化阶段
          if (ik->is_initialized() && ik->can_be_fastpath_allocated() ) {
            size_t obj_size = ik->size_helper();
            oop result = NULL;
            // 记录是否需要将对象所有字段置为零值
            bool need_zero = !ZeroTLAB;
            // 是否在 TLAB 中分配对象
            if (UseTLAB) {
              result = (oop) THREAD->tlab().allocate(obj_size);
            }
            // Disable non-TLAB-based fast-path, because profiling requires that all
            // allocations go through InterpreterRuntime::_new() if THREAD->tlab().allocate
            // returns NULL.
#ifndef CC_INTERP_PROFILE
            if (result == NULL) {
              need_zero = true;
              // 直接在 eden 中分配对象
            retry:
              HeapWord* compare_to = *Universe::heap()->top_addr();
              HeapWord* new_top = compare_to + obj_size;
              // cmpxchg 是 x86 中的 CAS 指令,这里是一个 C++ 方法,通过 CAS 的方式分配空间,并发失败的话,赚到 retry 中重试,直到分配成功为止
              if (new_top <= *Universe::heap()->end_addr()) {
                if (Atomic::cmpxchg(new_top, Universe::heap()->top_addr(), compare_to) != compare_to) {
                  goto retry;
                }
                result = (oop) compare_to;
              }
            }
#endif
            if (result != NULL) {
              // 如果需要,为对象初始化零值
              if (need_zero ) {
                HeapWord* to_zero = (HeapWord*) result + sizeof(oopDesc) / oopSize;
                obj_size -= sizeof(oopDesc) / oopSize;
                if (obj_size > 0 ) {
                  memset(to_zero, 0, obj_size * HeapWordSize);
                }
              }
              // 根据是否使用偏向锁,设置对象头信息
              if (UseBiasedLocking) {
                result->set_mark(ik->prototype_header());
              } else {
                result->set_mark(markOopDesc::prototype());
              }
              result->set_klass_gap(0);
              result->set_klass(ik);
              // Must prevent reordering of stores for object initialization
              // with stores that publish the new object.
              OrderAccess::storestore();
              // 将对象引用入栈,继续执行下一条指令
              SET_STACK_OBJECT(result, 0);
              UPDATE_PC_AND_TOS_AND_CONTINUE(3, 1);
            }
          }
        }
2.3.2 对象的内存布局
HotSpot虚拟机对象在堆内存的存储布局分为3个部分:
对象头 Header实例数据 InstnaceData对齐填充 Padding
对象头包括两类信息:
**第一类**用于存储「对象自身的运行时数据」,如 哈希码(HashCode)、GC 分代年龄、锁状态标志、线程持有的锁、偏向线程ID、偏向时间戳等。这部分数据在 32位和64位虚拟机中的长度分别为 32 和 64 个比特,官方称这部分为 "Mark Word"
对象需要存储的运行时数据很多,其实已经超出了 32、64位 Bitmap 结构所能记录的最大限度,但是对象头里的信息是与对象自身定义的数据无关的额外存储成本,考虑到虚拟机的空间效率,Mark Word 被设计成一个有着动态定义的数据结构,目的是在极小的空间内存储尽可能多的数据,根据对象的状态复用自己的存储空间。
例如在 32位 的 HotSpot 虚拟机中,对象未被同步锁锁定的状态下, Mark Word 的 32个 比特存储空间中的 25个 比特存储对象哈希吗,4个比特存储对象分代年龄,2个比特存储锁标志位,1个比特固定为0.
在其他状态(轻量级锁定,重量级锁定,GC标记、可偏向)下对象的存储内容如下表所示:
| 存储内容 |
标志位 |
状态 |
| 对象哈希码、对象分代年龄 |
01 |
未锁定 |
| 指向锁记录的指针 |
00 |
轻量级锁定 |
| 指向重量级锁的指针 |
10 |
膨胀(重量级锁定) |
| 空、不需要记录信息 |
11 |
GC 标记 |
| 偏向线程ID、偏向时间戳、对象分代年龄 |
01 |
可偏向 |
对象头中的另一部分存储的是 「类型指针」,即对象指向它的类型元数据的指针(也就是 Class类?),Java 虚拟机通过这个指针来确定该对象是哪个类的实例。
并不是所有虚拟机实现都必须在对象数据上保留类型指针,也就是说查找对象的元数据信息并不一定要经过对象本身。
如果对象是一个 Java 数组,那在对象头中还必须有一块用于记录数组长度的数据,因为虚拟机可以通过普通 Java 对象的元数据信息确定 Java 对象的大小,但是如果数组的长度是不确定的,则无法通过元数据中的信息推断出数组的大小。
代码清单 2-2 是 HotSpot 虚拟机代表 Mark Word 中的代码(markOop.ccp) 注释片段,它描述了 32位虚拟机 Mark Word 的存储布局
【这里我本地只有 JDK 13的 markOop.ccp 文件,而在 JDK13中,是没有下面这段注释的】
// Bit-format of an object header (most significant first, big endian layout below):
// // 32 bits:
// -------// hash:25 ------------>| age:4 biased_lock:1 lock:2 (normal object)
// JavaThread*:23 epoch:2 age:4 biased_lock:1 lock:2 (biased object)
// size:32 ------------------------------------------>| (CMS free block)
// PromotedObject*:29 ---------->| promo_bits:3 ----->| (CMS promoted object)
【JDK13的 markOop.ccp】
/*
 * Copyright (c) 1997, 2019, Oracle and/or its affiliates. All rights reserved.
 * DO NOT ALTER OR REMOVE COPYRIGHT NOTICES OR THIS FILE HEADER.
 *
 * This code is free software; you can redistribute it and/or modify it
 * under the terms of the GNU General Public License version 2 only, as
 * published by the Free Software Foundation.
 *
 * This code is distributed in the hope that it will be useful, but WITHOUT
 * ANY WARRANTY; without even the implied warranty of MERCHANTABILITY or
 * FITNESS FOR A PARTICULAR PURPOSE.  See the GNU General Public License
 * version 2 for more details (a copy is included in the LICENSE file that
 * accompanied this code).
 *
 * You should have received a copy of the GNU General Public License version
 * 2 along with this work; if not, write to the Free Software Foundation,
 * Inc., 51 Franklin St, Fifth Floor, Boston, MA 02110-1301 USA.
 *
 * Please contact Oracle, 500 Oracle Parkway, Redwood Shores, CA 94065 USA
 * or visit www.oracle.com if you need additional information or have any
 * questions.
 *
 */

#include "precompiled.hpp"
#include "oops/markOop.hpp"
#include "runtime/thread.inline.hpp"
#include "runtime/objectMonitor.hpp"

void markOopDesc::print_on(outputStream* st) const {
  if (is_marked()) {  // last bits = 11
    st->print(" marked(" INTPTR_FORMAT ")", value());
  } else if (has_monitor()) {  // last bits = 10
    // have to check has_monitor() before is_locked()
    st->print(" monitor(" INTPTR_FORMAT ")=", value());
    ObjectMonitor* mon = monitor();
    if (mon == NULL) {
      st->print("NULL (this should never be seen!)");
    } else {
      mon->print_on(st);
    }
  } else if (is_locked()) {  // last bits != 01 => 00
    // thin locked
    st->print(" locked(" INTPTR_FORMAT ")", value());
  } else {
    st->print(" mark(");
    // Biased bit is 3rd rightmost bit
    if (is_neutral()) {   // last bits = 001
      st->print("is_neutral");
      if (has_no_hash()) {
        st->print(" no_hash");
      } else {
        st->print(" hash=" INTPTR_FORMAT, hash());
      }
    } else if (has_bias_pattern()) {  // last bits = 101
      st->print("is_biased");
      JavaThread* jt = biased_locker();
      st->print(" biased_locker=" INTPTR_FORMAT " epoch=%d", p2i(jt), bias_epoch());
    } else {
      st->print("??");
    }
    st->print(" age=%d)", age());
  }
}
对象头中的实例数据部分是真正存储对象有效信息的部分,即我们在程序代码中定义的各种类型的实例字段内容,无论是从父类继承的,还是在子类中定义的字段,都会记录在这部分中。
这部分的存储顺序受到「虚拟机分配策略参数」(-XX:FieldAllocationStyle)和字段在 Java 源码中定义顺序的影响。HotSpot 虚拟机默认的分配顺序为
longs/doubles ——> ints ——> shorts/chars ——> bytes/booleans ——> oops(Ordinary Object Pointers)
其分配策略是:相同宽度的字段被分配到一起存放,在满足这个前提的条件下,在父类中定义的变量会出现在子类之前。如果 HotSpot 虚拟机的 +XX:CompactFields 参数值为 true(默认为 true),则子类中较窄的变量也允许插入父类变量的空虚之中,以节省出一点点空间。
对象的第三部分「对齐填充」并不是必须有的部分,也没有特别的含义,仅仅起到**占位符**的作用。由于 HotSpot 虚拟机的 自动内存管理系统要求对象起始地址必须是 8字节 的整数倍。 对象头部分已经被设计为正好是 8字节的倍数,因此,如果对象实例数据部分没有对齐 8字节整数倍的话就由对齐填充部分进行补全。
2.3.3 对象访问定位
创建对象的目的当然是访问对象,访问对象首先需要定位对象。 Java 程序通过栈上 reference 数据来操作堆上的具体对象。对象的具体访问方式由虚拟机自己实现,《Java 虚拟机规范》中对于 reference 只规定了它是一个指向对象的引用,并没有定义这个引用应该通过什么方式去定位、访问对象。
目前的主流方式有两种:
使用句柄。直接指针。
如果使用句柄,则 Java 堆中可能会划分出一块内存用来作为「句柄池」,reference 中存储的就是对象的句柄地址,而句柄中包含了「对象实例数据」与「类型数据」各自具体的地址信息。

如果使用直接指针访问, Java 堆中对象的内存布局就必须考虑如何放置访问类型数据的相关信息,reference 中存储的直接就是对象地址,如果只是访问对象本身的话,就不需要多一次间接访问的开销。
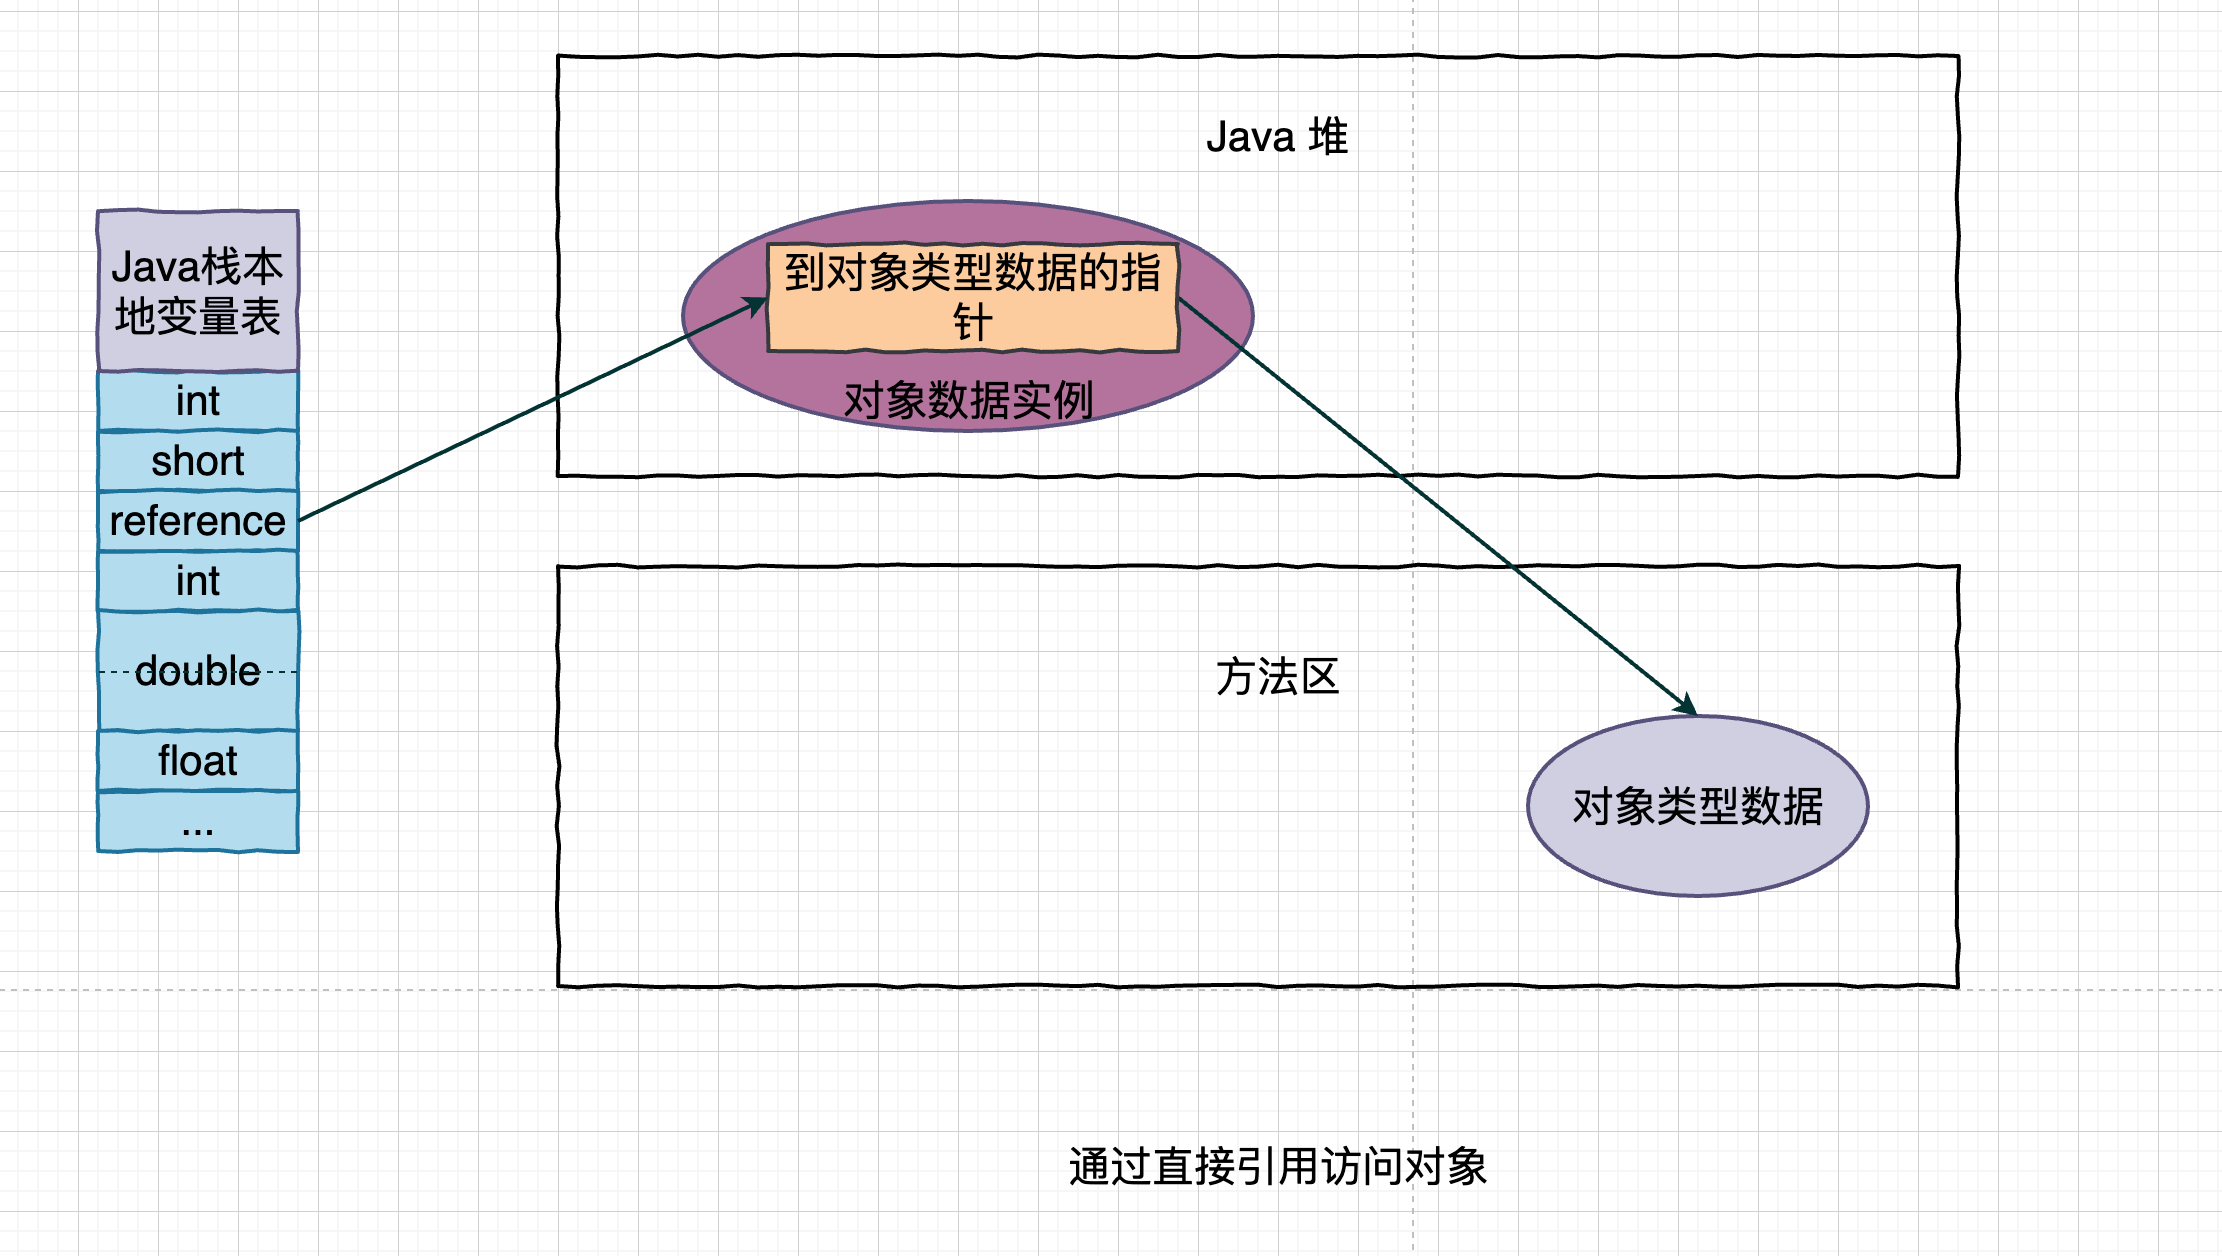
这两种访问方式各有优势:使用句柄访问最大的好处是在 reference 中存储的是稳定句柄地址,在对象被移动(垃圾收集时移动对象是非常普遍的行为)时只需要改变句柄中的实例数据指针,而 reference 本身不需要被修改。
使用直接指针访问最大的好处就是速度更快,省去了一次指针定位的时间开销,由于对象访问这个操作在虚拟机中非常频繁,所以这类开销积少成多也是一项极为客观的执行成本。
HotSpot 主要使用第二种方式进行对象访问(也存在例外,如果使用了 Shenandoah 收集器也会有一次额外的转发)。
但是在各种语言、框架中使用句柄来访问对象的方式也十分常见。
2.3 HotSpot虚拟机对象探秘
本章主要内容:
HotSpot虚拟机在Java 堆 中对象分配、布局和访问的全过程。2.3.1 对象的创建
最简单最常用的创建对象的方式:使用
new操作符。在虚拟机中,以下是虚拟机中普通对象(仅限普通 Java 对象,不包括数组和 Class 类型对象)的创建过程:当JVM 遇到一条内容是
new的字节码指令时,**首先检查**这个指令的参数是否能在常量池中定位到一个类的符号引用,并且检查这个符号引用代表的类是否已经被加载、解析和初始化过。如果没有,则执行「
类加载」过程。这个过程在第7章中详细探讨。当类加载检查通过后,
接下来虚拟机为新生对象分配内存。 对象所需的内存大小在类加载完成后就可以完全确定下来,为对象分配空间相当于把一块确定大小的内存块从 Java 堆中划分出来。假设 Java 堆中的内存是绝对规整的,所有被使用过的内存都放在一边,没有使用的放在另一边,中间存在一个指针作为分界点的指示器,那么分配内存只需要将指向向空闲空间方向挪动一段与对象大小相等的距离即可,这种方式叫做「
指针碰撞」(Bump The Pointer)。但如果 Java 堆中的内存并不是规整的,已被使用的内存和空间内存相互交错,那就没有办法简单地通过指针碰撞完成了,则虚拟机需要维护一个「
空闲列表」(Free List)。选择哪种分配方式由 Java 堆是否规整决定,而 Java 堆是否规整又取决于采用的垃圾收集器是否带有 「空间压缩整理」(Compact)能力决定。
因此,当使用
Serial、ParNew等带压缩整理过程的收集器时,系统采用的分配方法是「指针碰撞」,既简单又高效;当使用
CMS这种基于清除(Sweep)算法的收集器时,理论上就只能采用较为复杂的空闲列表来分配内存。除了划分可用空间,还需要考虑对象的创建是非常频繁的行为,有可能存在正在给对象A 分配内存,指针还没来得及修改,对象B又同时使用了原来的指针来分配内存的情况,针对这个问题有两种解决方案:
CAS(Compare And Swap)**配上失败重试的方式保证更新操作的原子性【举个例子呢?】XX: +/- UseTLAB参数设定内存分配完成之后,虚拟机的下一步工作就是「分配内存空间(
不包括对象头)」,初始化零值,如果使用了 TLAB 来创建对象,这一项工作也可以提前到 TLAB 分配时顺便进行。 这一步操作保证了对象的**实例字段在 Java 代码中可以不赋初始值就直接使用,因为虚拟机将这些字段初始化为了它们对应的零值。**从虚拟机的视角来看,初始化零值之后一个
新的对象就已经产生了。但是从Java程序视角来看,对象的创建才刚刚开始——构造函数还没有执行,所有的类实例字段都是默认的零值,对象需要的其他资源和状态信息也没有按照预定的意图构造好。一般来说,由字节码流中的
new指令后面是否跟随invokespecial指令所决定, Java 编译器会在遇到new关键字的地方同时生成这两条字节码指令,但如果直接通过其他方式产生的对象则不一定如此。 new 指令之后会接着执行<init>()方法,也就是构造函数中的对象初始化的内容,这样一个真正可用的对象才完全被构建完成。下面的
代码清单 2-1是HotSpot虚拟机字节码解释器(bytecodeInterpreter.cpp) 中的代码片段,这个解释器很少有机会实际使用 —— 大部分平台使用的都是模板解释器。当代码通过**
即时编译器**执行时差异就更大了,不过这段代码在用于了解HotSpot的运行过程是没有问题的。(作者添加了注释)2.3.2 对象的内存布局
HotSpot虚拟机对象在堆内存的存储布局分为3个部分:
对象头 Header实例数据 InstnaceData对齐填充 Padding对象头包括两类信息:
**
第一类**用于存储「对象自身的运行时数据」,如哈希码(HashCode)、GC 分代年龄、锁状态标志、线程持有的锁、偏向线程ID、偏向时间戳等。这部分数据在 32位和64位虚拟机中的长度分别为 32 和 64 个比特,官方称这部分为 "Mark Word"对象需要存储的运行时数据很多,其实已经超出了 32、64位
Bitmap结构所能记录的最大限度,但是对象头里的信息是与对象自身定义的数据无关的额外存储成本,考虑到虚拟机的空间效率,Mark Word 被设计成一个有着动态定义的数据结构,目的是在极小的空间内存储尽可能多的数据,根据对象的状态复用自己的存储空间。例如在 32位 的 HotSpot 虚拟机中,对象未被同步锁锁定的状态下, Mark Word 的 32个 比特存储空间中的
25个 比特存储对象哈希吗,4个比特存储对象分代年龄,2个比特存储锁标志位,1个比特固定为0.在其他状态(轻量级锁定,重量级锁定,GC标记、可偏向)下对象的存储内容如下表所示:
对象头中的另一部分存储的是 「类型指针」,即对象指向它的类型元数据的指针(也就是 Class类?),Java 虚拟机通过这个指针来确定该对象是哪个类的实例。
并不是所有虚拟机实现都必须在对象数据上保留类型指针,也就是说查找对象的元数据信息并不一定要经过对象本身。
如果对象是一个 Java 数组,那在对象头中还必须有一块用于记录数组长度的数据,因为虚拟机可以通过普通 Java 对象的元数据信息确定 Java 对象的大小,但是如果数组的长度是不确定的,则无法通过元数据中的信息推断出数组的大小。
代码清单 2-2 是 HotSpot 虚拟机代表 Mark Word 中的代码(
markOop.ccp) 注释片段,它描述了 32位虚拟机 Mark Word 的存储布局【这里我本地只有 JDK 13的
markOop.ccp文件,而在 JDK13中,是没有下面这段注释的】【JDK13的
markOop.ccp】对象头中的实例数据部分是真正存储对象有效信息的部分,即我们在程序代码中定义的各种类型的实例字段内容,无论是从
父类继承的,还是在子类中定义的字段,都会记录在这部分中。这部分的存储顺序受到「虚拟机分配策略参数」(
-XX:FieldAllocationStyle)和字段在 Java 源码中定义顺序的影响。HotSpot 虚拟机默认的分配顺序为其分配策略是:相同宽度的字段被分配到一起存放,在满足这个前提的条件下,在父类中定义的变量会出现在子类之前。如果 HotSpot 虚拟机的
+XX:CompactFields参数值为 true(默认为 true),则子类中较窄的变量也允许插入父类变量的空虚之中,以节省出一点点空间。对象的第三部分「对齐填充」并不是必须有的部分,也没有特别的含义,仅仅起到**
占位符**的作用。由于 HotSpot 虚拟机的 自动内存管理系统要求对象起始地址必须是 8字节 的整数倍。 对象头部分已经被设计为正好是 8字节的倍数,因此,如果对象实例数据部分没有对齐 8字节整数倍的话就由对齐填充部分进行补全。2.3.3 对象访问定位
创建对象的目的当然是访问对象,访问对象首先需要定位对象。 Java 程序通过栈上
reference数据来操作堆上的具体对象。对象的具体访问方式由虚拟机自己实现,《Java 虚拟机规范》中对于 reference 只规定了它是一个指向对象的引用,并没有定义这个引用应该通过什么方式去定位、访问对象。目前的主流方式有两种:
使用句柄。直接指针。如果使用句柄,则 Java 堆中可能会划分出一块内存用来作为「
句柄池」,reference中存储的就是对象的句柄地址,而句柄中包含了「对象实例数据」与「类型数据」各自具体的地址信息。如果使用直接指针访问, Java 堆中对象的内存布局就必须考虑如何放置访问类型数据的相关信息,reference 中存储的直接就是对象地址,如果只是访问对象本身的话,就不需要多一次间接访问的开销。
这两种访问方式
各有优势:使用句柄访问最大的好处是在reference中存储的是稳定句柄地址,在对象被移动(垃圾收集时移动对象是非常普遍的行为)时只需要改变句柄中的实例数据指针,而reference本身不需要被修改。使用直接指针访问最大的好处就是速度更快,省去了一次指针定位的时间开销,由于对象访问这个操作在虚拟机中非常频繁,所以这类开销积少成多也是一项极为客观的执行成本。
HotSpot主要使用第二种方式进行对象访问(也存在例外,如果使用了Shenandoah收集器也会有一次额外的转发)。但是在各种语言、框架中使用句柄来访问对象的方式也十分常见。