一期回顾个人总结:
- 并发出现的原因:为了提升性能,增加对硬件的利用率(单线程的话可能导致CPU长期闲置,大量的时间耗费在速度最慢的I/O操作上)演化过程:逐渐细化,起初是进程级别,后来细化到线程级别,对资源的控制越来越精细。
- 并发带来的问题:
硬件层面:CPU核心数目的增加带来的不同CPU缓存互相不可见的问题 —— 可见性。操作系统层面:线程之间切换导致了一个操作可能没有执行完线程就失去了CPU时间片,另一个线程如果对相同变量进行操作就会导致问题 —— 原子性。编程语言层面:源代码在编译过程中,编译器会在不改变最终结果的情况下对语言的执行顺序进行改变,但这种优化在并发环境中会带来问题 —— 有序性。
- 概念定义:
原子性: 一个或者多个操作在 CPU 执行的过程中不被中断。有序性: 程序按照代码的编写顺序依次执行。可见性: 一个线程对共享变量的修改,另一个线程能立刻看到。
- 经典案例:
原子性:多线程环境下对未使用同步机制的共享变量的并发修改场景。有序性:使用双重检查创建单例对象。可见性:在多线程环境下多个线程在不同CPU核心上操作共享变量。
- 一个技术的出现一定有着对应的时代背景,一定是为了某项改进,但是编程中没有银弹,技术的出现必然伴随着相关问题的出现,并发亦是如此。

并发程序幕后的故事

这些改进措施增强了程序的性能,却也带来了很多并发的诡异问题。
根据第二点:我想到了一个问题:**I/O 操作是完全不需要占用CPU资源,还是需要的CPU资源可以少到忽略不计?**不然怎样通过分时复用来解决I/O任务耗时长的问题呢?
带着这个疑问,我进行谷歌并搜到了一个类似的问题,其问题和我的一样,这个问题是:
阻塞I/O情况下,比如磁盘io,accept ,read,recv,write等调用导致进程或者线程阻塞,这时候**线程/进程 会占用cpu吗**?
比如连接mysql,执行一条需要执行很长的sql语句,recv调用的时候阻塞了,这个时候会不会大量占用cpu时间?
磁盘io是什么操作,比如linux调用cp拷贝大文件的时候会大量占用cpu吗?
而对应这个问题的高赞回答是这么说的:
这是一个很好的并发/并行 系统的问题。 简单的回答是:I/O 所需要的 CPU资源非常少。大部分工作分派给 DMA 来完成。
【这里又引入了一个问题,什么是 DMA?带着这个问题我继续往下看】
先不谈传统 5大 I/O 模型,只说并发 —— 一个非常不严谨的解释就是同时做A和B两件事,先做一会进程A,然后上下文切换,再做一会B,过一会再切回来继续做A。 因此给我们造成一种假象:我们同时在做 A 和 B 两件事。
这就是著名的**「进程模型」**。
但是做完A再做B 和 做一会切换过去做一会B 最终耗时应该是相同的,并且还多了上下文的切换开销,所以问题肯定不是这么简单。
所以,如果计算机内部不止CPU 一个部件在工作呢? A这件事可以由 CPU 分派给其他部件帮它完成,情况就完全不一样了。
【也就是 CPU 只是一个包工头,负责分配工作。】
系统I/O正好是这样一个完美的例子:
对于磁盘I/O,真实发生的场景可能是这样:
CPU:硬盘我要把一份资料拷贝进「主存」。
硬盘:好的,我完成后叫你。
CPU:好的,那我干别的事儿去了。
CPU干别的事儿中
硬盘:CPU,你吩咐的事儿已经做完了。
CPU:好的,继续完成将资料拷贝进主存后的后续工作。
上面的场景不仅适用于 硬盘I/O,也适用于 网络I/O。 基本情况一样,CPU在等待长时间的 I/O任务中,可以切换到其他任务。
正因为这样派发任务,通讯,等待的过程,并发系统才彰显了其存在的意义。
实际过程可能比上面的例子复杂很多,比如 CPU 和 硬盘不会直接沟通,它们通过一个**中间人**,它就是 DMA(Direct Memory Access)芯片来进行通讯。
CPU 计算文件地址 ——> 委派 DMA 读取文件 ——> DMA 接管总线 ——> CPU 的 A进程阻塞,挂起 ——> CPU 切换到进程B ——> DMA 读取完文件后通知CPU(一个中断异常) ——> CPU 切换回 A进程操作文件
【这个过程,对应下面这个来自**《UNIX 网络编程》**的一张图。】
application的这一列时间线,aio_read 操作之后都是空白,CPU就不管了,可以做其他事情去了。

【这里原图比较模糊,我对照着重制了一张比较清晰的,原网页在这里:6.2 I/O Models这里列举了几大 I/O 模型,很有参考价值】
假设原先读取文件需要CPU傻等50纳秒,现在尽管切换两次上下文要消耗5纳秒,CPU还是赚了40纳秒的时间片。
上面这张图是 传统五大I/O模型中的 异步I/O的大致过程,想详细了解请看 **《UNIX 网络编程》**第一册 套接字。
【↑以上是原问题答案,回答的非常好,同时又引入了传统5大I/O 模型这个概念,刚好我对I/O的理解不是很深,甚至只知道AIO,BIO,NIO 这样的概念而已,所以这方面也非常值得进行深入学习。】
源头一:缓存导致可见性问题

单核时代,所有线程都在同一个 CPU 上执行, CPU 缓存与 内存数据的一致性容易解决。 因为所有线程都操作的是同一个 CPU 的缓存,一个线程对缓存的写,对另外一个线程来说一定是可见的。
示例图如下:
线程A 和 线程B 都操作同一个 CPU 里面的缓存,所以线程A 更新了 变量 V 的值,那么线程B 之后访问变量V 得到的一定是 V 的最新值。(线程A 写入的值)

一个线程对共享变量的修改,另一个线程能立刻看到,称为「可见性」。
多核时代,每颗 CPU 都有自己的缓存,这时 CPU 缓存与内存的数据一致性就没那么容易解决了。
当多个线程在不同 CPU 上执行时,这些线程操作的是不同的 CPU 缓存。 比如下图中,线程A 操作的是 CPU-1 上的缓存,而线程B 操作的是 CPU-2 上的缓存,很明显,这个 「线程A」 对 「变量V」 的操作对于 「线程B」 来说就**不具备可见性**了。

下面使用一段代码来验证「多核场景」下的 「可见性问题」。
下面的代码,每执行一次 add10K() 方法,都会循环 10000 次 count += 1 的操作。 在 calc() 方法中我们创建了两个线程,每个线程调用一次 add10K() 方法,那么 calc() 方法的结果应该是多少?
@Slf4j
public class Test {
    private long count = 0;

  	// 对 count 进行递增的方法,每次调用完成将 count 的值递增为 10k
    private  void add10K() {
        int idx = 0;
        while (idx++ < 10000) {
            count += 1;
        }
        log.info("add10k()方法执行完毕时Count的值: ---> {}",count);
    }

    public static long calc() throws InterruptedException {
        final Test test = new Test();
      	// 创建两个线程,分别在各自线程中执行将 count 递增为10k 的方法
        Thread th1 = new Thread(test::add10K);
        Thread th2 = new Thread(test::add10K);

        // 启动 th1,th2 线程
        th1.start();
        th2.start();
        // 等待两个线程执行完成后返回 count 的值
        th1.join();
        th2.join();
        return test.count;
    }

    public static void main(String[] args) throws InterruptedException {
        for (int i = 0; i < 10; i++) {
            long calc = Test.calc();
            log.info("本次返回结果{}",calc);
        }
    }
}


/**
输出
[INFO ]-Thread-0-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10697
[INFO ]-Thread-1-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 12674
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果12674
[INFO ]-Thread-2-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-3-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 14978
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果14978
[INFO ]-Thread-4-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 12777
[INFO ]-Thread-5-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 16389
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果16389
[INFO ]-Thread-6-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10032
[INFO ]-Thread-7-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 14018
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果14018
[INFO ]-Thread-8-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10261
[INFO ]-Thread-9-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 15359
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果15359
[INFO ]-Thread-10-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 12575
[INFO ]-Thread-11-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 19471
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果19471
[INFO ]-Thread-12-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-13-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-15-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 17697
[INFO ]-Thread-14-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 15704
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果17697
[INFO ]-Thread-16-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10027
[INFO ]-Thread-17-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 17544
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果17544
[INFO ]-Thread-18-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-19-[2020-04-09 15:06:31]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:06:31]-[chapter1.Test:43]: 本次返回结果20000

Process finished with exit code 0

*/
【这里我给文章中的样例代码加了10次循环,并且增加了log输出,可以非常直观的看到,add10K() 是一个非同步的方法,在仅仅只有2个线程的并发环境下,也只有1次成功输出了正确数值。】
【然后我使用 synchronized 关键字 给这个方法加一个锁,再执行看看结果:】
@Slf4j
public class Test {
    private long count = 0;

    private  synchronized void add10K() {
        int idx = 0;
        while (idx++ < 10000) {
            count += 1;
        }
        log.info("add10k()方法执行完毕时Count的值: ---> {}",count);
    }

    public static long calc() throws InterruptedException {
        final Test test = new Test();
        Thread th1 = new Thread(test::add10K);

        Thread th2 = new Thread(test::add10K);

        // 启动 th1,th2 线程
        th1.start();
        th2.start();
        // 等待两个线程执行结束 th1.join(); th2.join();
        th1.join();
        th2.join();
        return test.count;
    }

    public static void main(String[] args) throws InterruptedException {
        for (int i = 0; i < 10; i++) {
            long calc = Test.calc();
            log.info("本次返回结果{}",calc);
        }
    }
}

/**
输出
[INFO ]-Thread-0-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-1-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:17]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-2-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-3-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:17]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-4-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-5-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:17]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-6-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-7-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:17]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-8-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-9-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:17]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-10-[2020-04-09 15:07:17]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-11-[2020-04-09 15:07:18]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:18]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-12-[2020-04-09 15:07:18]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-13-[2020-04-09 15:07:18]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:18]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-14-[2020-04-09 15:07:18]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-15-[2020-04-09 15:07:18]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:18]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-16-[2020-04-09 15:07:18]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-17-[2020-04-09 15:07:18]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:18]-[chapter1.Test:43]: 本次返回结果20000
[INFO ]-Thread-18-[2020-04-09 15:07:18]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 10000
[INFO ]-Thread-19-[2020-04-09 15:07:18]-[chapter1.Test:22]: add10k()方法执行完毕时Count的值: ---> 20000
[INFO ]-main-[2020-04-09 15:07:18]-[chapter1.Test:43]: 本次返回结果20000

*/
【可以看到**加锁**之后的方法,每次执行完成都和我们预期的结果一致 count == 20000。】
这里之前造成 calc() 结果是 10000 到 20000 之间随机数的原因是:
假设 「线程A」 和 「线程B」 同时开始执行,那么第一次都会将 count = 0 读取到各自的 「CPU 缓存」中,执行完 count += 1 之后,各自 「CPU 缓存」 中的值都是1,同时写入内存后,我们会发现内存中的值 是 1 而不是 期望值 2 。 之后由于各自的 CPU缓存 中都有了 count的值,两个线程都是基于 CPU 缓存里的 count 进行计算,所以导致最终的 count 的值小于 20000,这就是 「缓存可见性」 问题。

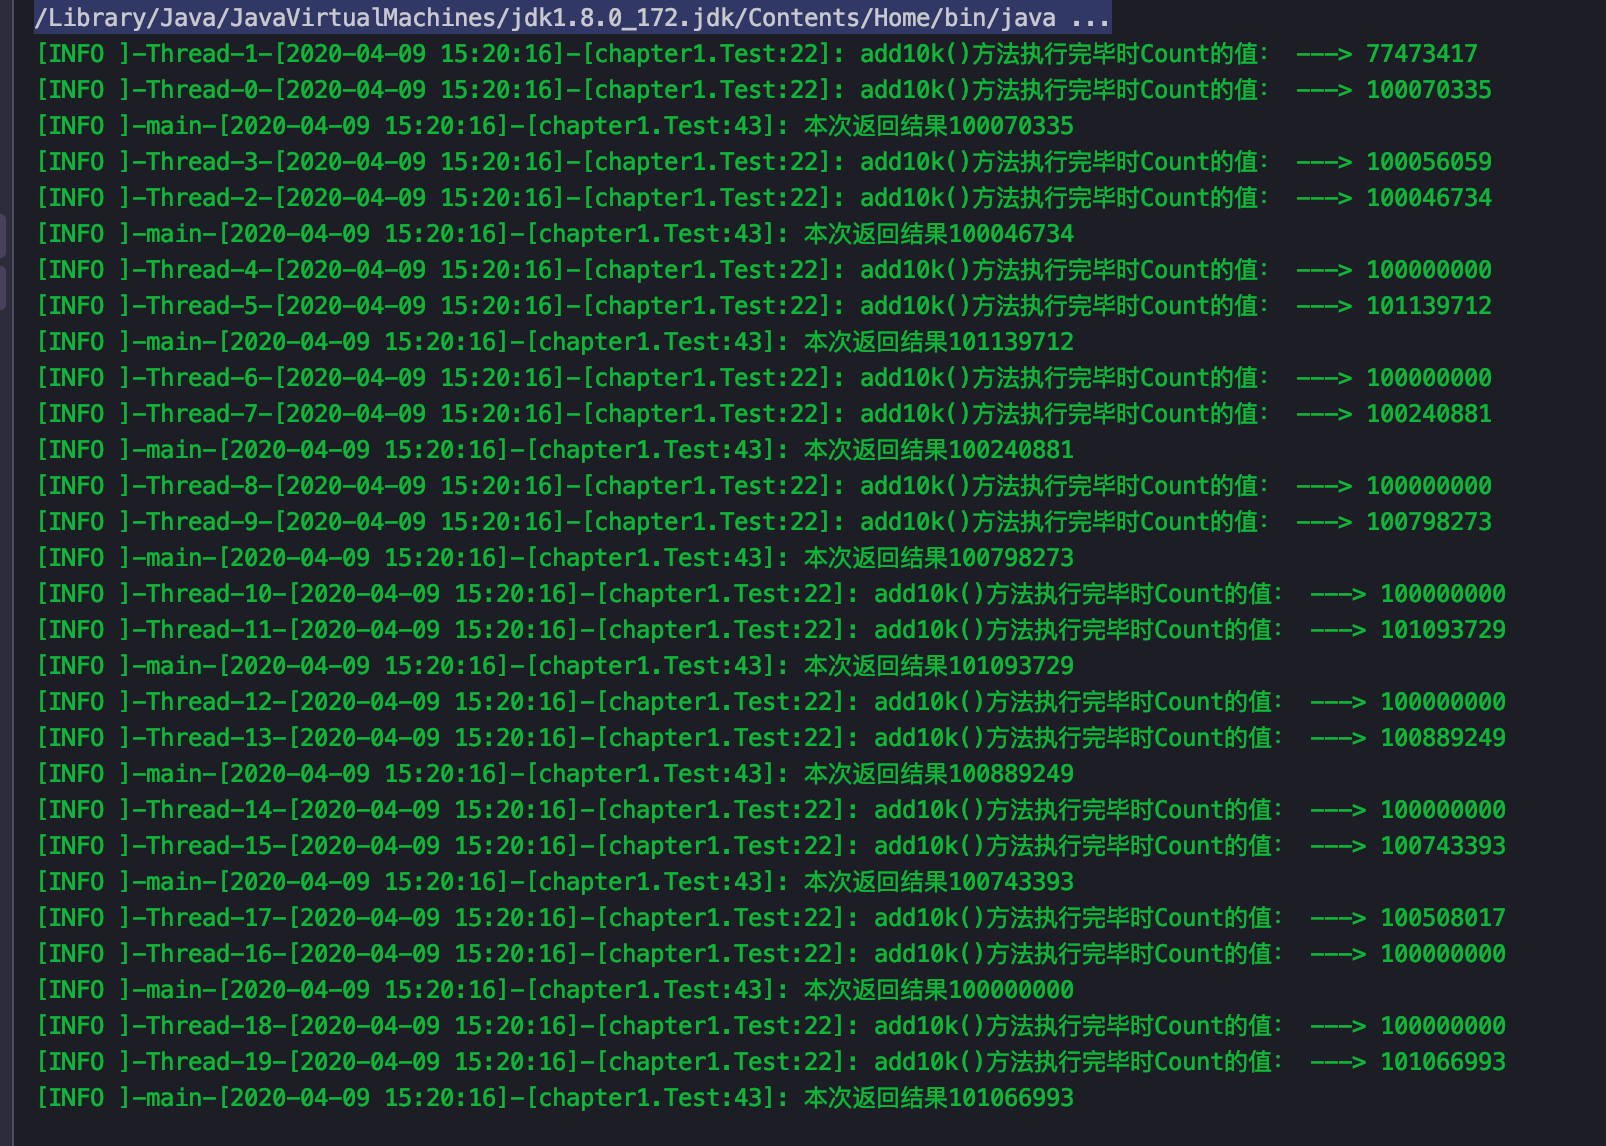
如果将循环条件从 10000 次 改为 1亿次,那么结果会更加明显,最终的 count 值更接近1亿 而不是 2亿。 在这个循环 10000 次的例子中,count 接近 10000 是**因为两个线程并非同时启动,有一个时差,所以在循环小的情况下,更接近目标值,而当循环大的情况下,则更接近于目标值的一半**。
【将循环条件改为 「1亿次」 之后,结果确实 如作者所说,更接近 1亿。】
源头二:线程切换带来的「原子性」 问题
由于 I/O 速度太慢,早期的**操作系统就发明了「多进程」,即便在单核 CPU** 上我们也可以一边听歌一边做别的,给人一种这几件事并行的错觉,其实是CPU在以极小的时间分片进行切换,每个进程执行一个**「时间片」**的时间 例如 50ms , 这就是 多进程的功劳。
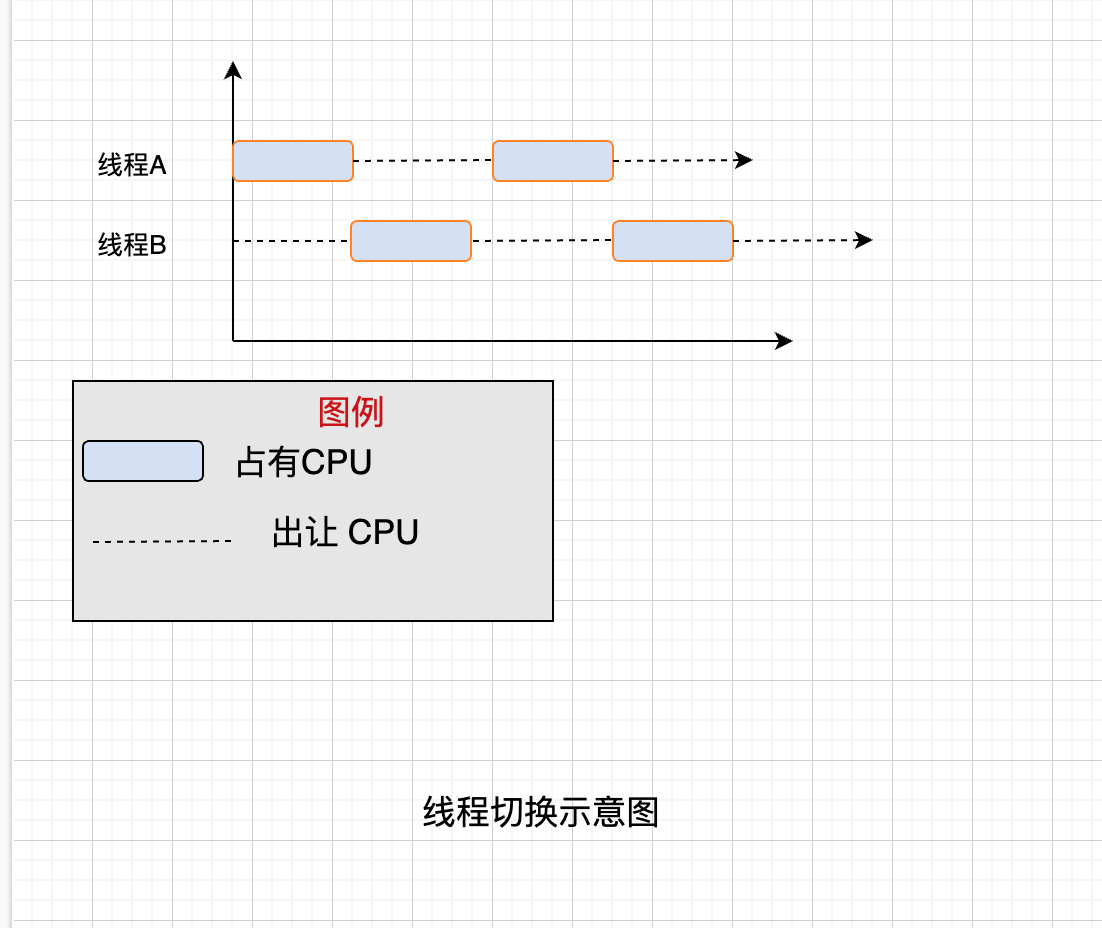
在一个时间片内,如果一个进程进行一个 I/O 操作,例如**「读取一个文件」,这个时候进程可以把自己标记为 「休眠状态」 并 出让 CPU 的使用权,当文件读取进内存这个 I/O 操作结束后**, 「操作系统」会把这个休眠的进程唤醒,唤醒后的进程就有机会重新获得 CPU 的使用权了。
这里的 「进程」 在等待 I/O 时之所以会释放 CPU 使用权,是为了让 CPU 在这段等待的时间里可以做别的事情,这样一来,CPU 的使用率就增加了。
如果这时**另一个进程也在读取文件**,读取文件的操作就会排队,磁盘驱动在完成一个进程的读操作后,发现有排队的任务,就会立即启动下一个读操作,这样 I/O 的使用率也增加了。
虽然这个逻辑看上去很简单,但是支持 「进程分时复用」 在操作系统的发展史上有着 「里程碑」 的意义,Unix 因为解决了这个问题而名噪天下。
「早期的操作系统」基于「进程」 来调度 CPU,不同的进程之间不共享「内存空间」,所以切换任务就需要切换进程,从而切换「内存映射地址」,而一个进程创建的所有线程,则共享同一个内存空间,所以线程之间的切换成本比进程间切换要低很多。 现代的操作系统都是基于更轻量的线程来调度,所以我们现在提到的「任务切换」 指的都是 「线程切换」。
Java 并发程序都是基于 多线程的,自然也会涉及到 「任务切换」。而同时任务切换也是 Java 并发中 Bug 的源头之一。
「任务切换」 的时机大多数是在 时间片结束的时候,我们现在使用的基本都是高级编程语言,而高级编程语言中的一行代码往往对应着多个 CPU 指令操作。
比如上面代码中的 count += 1 就对应着 3个操作。
指令1 读取:将 count 内存加载到 **CPU 寄存器**中指令2 修改:将 count 在寄存器中进行 +1 操作指令3 写入:将寄存器中的结果写入内存。(缓存机机制导致可能写入的是 CPU 缓存而不是 内存)
操作系统做任务切换,可以发生在任何一条 「CPU 指令」 执行完成的时候,而不是 高级编程语言中的一条语句。 ↑---【这里对原子性的解释要比 jcip 中更具体一些,我理解的原子性指的是一组高级语句中对应的所有 CPU 指令一起执行完成 才发生切换】
对于上面的三条指令来说,假设 count = 0,如果 线程A 在 指令1 执行完成后进行了线程切换,线程A 和 线程B 按照下图的顺序执行,那么我们会发现两个线程都执行了 count += 1 的操作,且 count 的值都是以 0 为起点,最终得到的结果是 1 而不是期望的 2。

我们将一个或者多个操作在 CPU 执行的过程中不被中断的特性称为 「原子性」 <---【对原子性的定义】。
CPU 能保证的原子操作需要是 CPU指令级别的,而不是高级语言的操作符。
这是违背我们直觉的地方,因此很多时候我们需要在**「高级语言层面」**保证操作的原子性。
【所以这一节的内容对于《jcip》 中所讲的 复合操作 带来的线程安全性问题,最终追溯到 Java 中的原子操作是保证线程安全的重要手段】
源头之三:编译优化带来的有序性问题
【也就是**重排序**问题】
并发编程中还有一个容易导致违背直觉性的诡异BUG的原因就是**有序性**。
有序性指的是 程序按照代码的先后顺序执行。 【<--- 对于有序性的定义】
但是**编译器为了优化性能**,有时候会改变程序中语句的先后顺序,例如 a=6,b=7 编译后可能变成了 b=7,a=6 这个顺序。 **编译器调整了语句的顺序,但是不影响程序的最终结果。**但是有时候编译器和解释器的优化可能导致意想不到的Bug。
Java 中的一个经典的关于有序性问题的按理就是利用 「双重检查」 创建单例对象,例如下面的代码:
在获取实例 getInstnace() 方法中,首先判断 intance 是否为空,如果为空则锁定 Singleton.class 并再次检查 instance 是否为空,如果还未空则创建 Singleton 的一个实例。
// 一个双重检查的单例代码示例
public class Singleton {
    static Singleton instance;

    static Singleton getInstance() {
        if (instance == null) {
            synchronized (Singleton.class) {
                if (instance == null) {
                    instance = new Singleton();
                }
            }
        }
        return instance;
    }
}假设有两个线程A、B 同时调用 getInstance() 方法,则同时发现 instance == null , 于是同时对 Singleton.class 加锁,此时 JVM 保证只有一个线程能够加锁成功(假设是 线程A),此时另外一个线程会处于等待状态,线程A 创建一个 Singleton 实例,然后释放锁,锁被释放后 线程B 被唤醒,线程B 尝试加锁 ,本次加锁可以成功,然后线程B 检查 instance == null 发现已经有实例被创建,所以线程B 不会再创建一个 SIngleton 实例。
看上去很完美,但是实际上 getInstance() 方法存在漏洞, 问题出在 new 这个操作符上。
我们以为的使用 new 操作符构造对象的流程:
分配一块内存 M- 在内存上
初始化 Singleton 对象
- 将 M 的地址
赋值给 instance 变量
但是实际上被优化后的执行路径却是这样的:
分配一块内存 M- 将
M 的地址赋值给 instance 变量
- 在 内存 M 上
初始化 Singleton 对象。
两者区别就在于,优化后的情况当对象尚未初始化完成的时候就已经被赋值给栈中的引用,此时就已经可以获得该对象了。
这样将会导致:
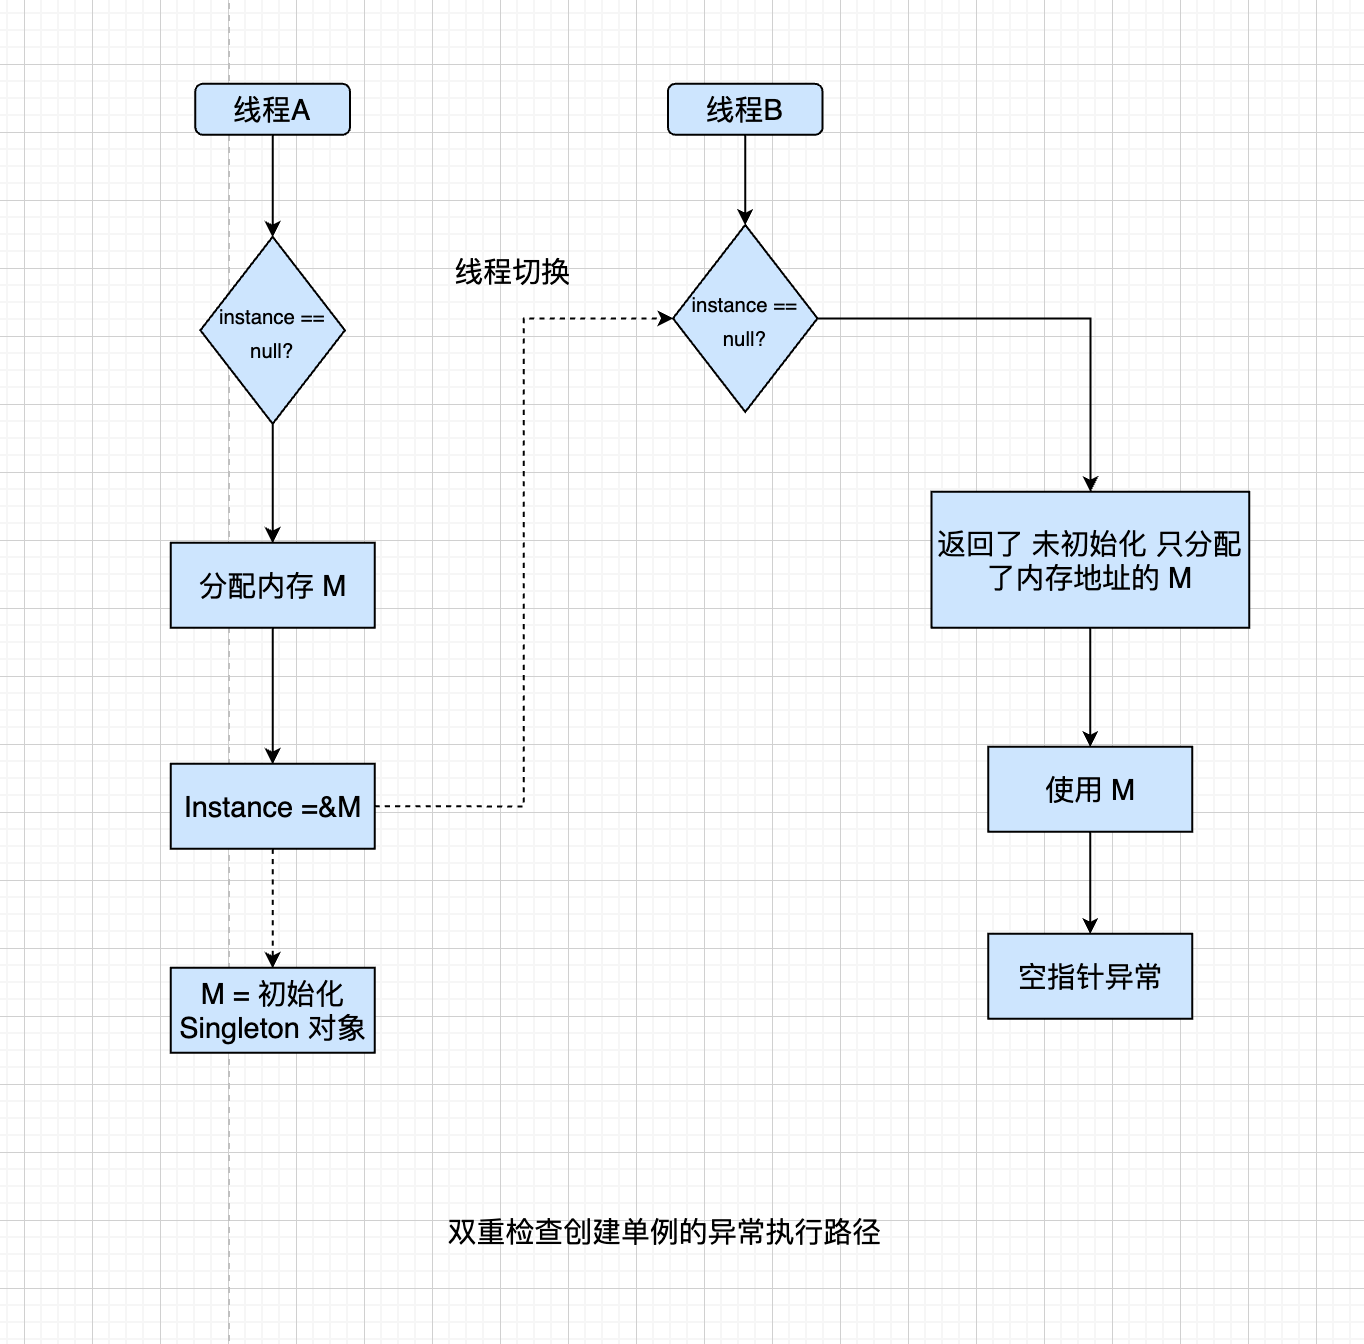
线程A 先执行 getInstance() 方法,当执行完指令2时发生了线程切换,此时线程B 也执行了 getInstance() 方法,进入判断 instance != null 是 true,所以直接返回了 instance,而此时的 instance 因为**指令重排序的原因,先将堆内存中的地址值赋值给栈中的引用,下面才对堆中对象真正进行初始化,所以此时的 instance 是一个尚未初始化完成的对象**,如果这个时候直接使用的话,就可能触发 「空指针异常」。
【↑所以这里的B 存在的是可见性的问题,此时它看到的是一个未构建成功的 instance 实例】
【这里说明的是「构造函数」 并不是一个原子操作,未构建完成的对象可能被逸出,导致某些错误的发生,这个是之前我看《Java 并发编程实战》时当时没太理解的一个点,再次看到这个专门看到这个解释我明白了。】
下面是对于这个双重检查单例类的流程图解释:
【既然存在这个问题,那么怎么解决呢?】
答案:使用 volatile 修饰 instance,这样就保证了编译器不会对其进行指令重排序,保证了线程B看到的 Instance 对象是已经初始化完成的可用对象。
总结
想写好并发程序,首先要知道并发程序的问题可能出现在哪里,是因为什么导致的。
只要我们可以深刻的理解 可见性、原子性、有序性 在并发场景下的原理,就可以对 Bug 进行比较准确的诊断。
这里作者特意提到了缓存导致的可见性问题,线程切换带来的原子性问题,编译优化导致的有序性问题。这些手段的目的都是为了提高性能,但是技术再解决一个问题的同事必然会带来新的问题。
在采用一项技术的同时,一定要清楚它带来的问题是什么,以及如何规避。
专栏和书比起来,知识密度少了许多,所以阅读起来比较轻松, 再加上之前已经使用《jcip》 对并发的基础知识进行了一轮学习,所以对于专栏的学习更多的是加深理解,查漏补缺。 同时更多的实践。
一期回顾个人总结:
硬件层面:CPU核心数目的增加带来的不同CPU缓存互相不可见的问题 —— 可见性。操作系统层面:线程之间切换导致了一个操作可能没有执行完线程就失去了CPU时间片,另一个线程如果对相同变量进行操作就会导致问题 —— 原子性。编程语言层面:源代码在编译过程中,编译器会在不改变最终结果的情况下对语言的执行顺序进行改变,但这种优化在并发环境中会带来问题 —— 有序性。原子性:一个或者多个操作在CPU执行的过程中不被中断。有序性:程序按照代码的编写顺序依次执行。可见性:一个线程对共享变量的修改,另一个线程能立刻看到。原子性:多线程环境下对未使用同步机制的共享变量的并发修改场景。有序性:使用双重检查创建单例对象。可见性:在多线程环境下多个线程在不同CPU核心上操作共享变量。并发程序幕后的故事
这些改进措施增强了程序的性能,却也带来了很多并发的诡异问题。
根据第二点:我想到了一个问题:**
I/O操作是完全不需要占用CPU资源,还是需要的CPU资源可以少到忽略不计?**不然怎样通过分时复用来解决I/O任务耗时长的问题呢?带着这个疑问,我进行谷歌并搜到了一个类似的问题,其问题和我的一样,这个问题是:
而对应这个问题的高赞回答是这么说的:
正因为这样
派发任务,通讯,等待的过程,并发系统才彰显了其存在的意义。实际过程可能比上面的例子复杂很多,比如
CPU和硬盘不会直接沟通,它们通过一个**中间人**,它就是DMA(Direct Memory Access)芯片来进行通讯。【这个过程,对应下面这个来自**
《UNIX 网络编程》**的一张图。】application的这一列时间线,aio_read操作之后都是空白,CPU就不管了,可以做其他事情去了。【这里原图比较模糊,我对照着重制了一张比较清晰的,原网页在这里:6.2 I/O Models这里列举了几大
I/O 模型,很有参考价值】假设原先读取文件需要
CPU傻等50纳秒,现在尽管切换两次上下文要消耗5纳秒,CPU还是赚了40纳秒的时间片。上面这张图是
传统五大I/O模型中的异步I/O的大致过程,想详细了解请看 **《UNIX 网络编程》**第一册 套接字。【↑以上是原问题答案,回答的非常好,同时又引入了传统5大I/O 模型这个概念,刚好我对I/O的理解不是很深,甚至只知道AIO,BIO,NIO 这样的概念而已,所以这方面也非常值得进行深入学习。】
源头一:缓存导致可见性问题
单核时代,所有线程都在同一个 CPU上执行,CPU 缓存与内存数据的一致性容易解决。 因为所有线程都操作的是同一个CPU的缓存,一个线程对缓存的写,对另外一个线程来说一定是可见的。示例图如下:
线程A和线程B都操作同一个 CPU 里面的缓存,所以线程A更新了变量 V的值,那么线程B之后访问变量V得到的一定是V的最新值。(线程A写入的值)一个线程对共享变量的修改,另一个线程能立刻看到,称为「
可见性」。多核时代,每颗 CPU 都有自己的缓存,这时CPU 缓存与内存的数据一致性就没那么容易解决了。当
多个线程在不同 CPU 上执行时,这些线程操作的是不同的 CPU 缓存。 比如下图中,线程A操作的是CPU-1上的缓存,而线程B操作的是CPU-2上的缓存,很明显,这个 「线程A」 对 「变量V」 的操作对于 「线程B」 来说就**不具备可见性**了。下面使用一段代码来验证「
多核场景」下的 「可见性问题」。下面的代码,每执行一次
add10K()方法,都会循环10000次count += 1的操作。 在calc()方法中我们创建了两个线程,每个线程调用一次add10K()方法,那么calc()方法的结果应该是多少?【这里我给文章中的样例代码加了
10次循环,并且增加了log输出,可以非常直观的看到,add10K()是一个非同步的方法,在仅仅只有2个线程的并发环境下,也只有1次成功输出了正确数值。】【然后我使用
synchronized关键字 给这个方法加一个锁,再执行看看结果:】【可以看到**
加锁**之后的方法,每次执行完成都和我们预期的结果一致count == 20000。】这里之前造成
calc()结果是10000到20000之间随机数的原因是:假设 「
线程A」 和 「线程B」同时开始执行,那么第一次都会将count = 0读取到各自的 「CPU 缓存」中,执行完count += 1之后,各自 「CPU 缓存」 中的值都是1,同时写入内存后,我们会发现内存中的值 是1而不是 期望值2。 之后由于各自的CPU缓存中都有了count的值,两个线程都是基于CPU 缓存里的count进行计算,所以导致最终的count的值小于20000,这就是 「缓存可见性」 问题。如果将循环条件从
10000次 改为1亿次,那么结果会更加明显,最终的count值更接近1亿 而不是 2亿。 在这个循环10000次的例子中,count接近10000是**因为两个线程并非同时启动,有一个时差,所以在循环小的情况下,更接近目标值,而当循环大的情况下,则更接近于目标值的一半**。【将循环条件改为 「1亿次」 之后,结果确实 如作者所说,更接近 1亿。】
源头二:线程切换带来的「原子性」 问题
由于
I/O 速度太慢,早期的**操作系统就发明了「多进程」,即便在单核 CPU** 上我们也可以一边听歌一边做别的,给人一种这几件事并行的错觉,其实是CPU在以极小的时间分片进行切换,每个进程执行一个**「时间片」**的时间 例如50ms, 这就是多进程的功劳。在一个时间片内,如果一个
进程进行一个I/O操作,例如**「读取一个文件」,这个时候进程可以把自己标记为 「休眠状态」 并出让CPU 的使用权,当文件读取进内存这个I/O操作结束后**, 「操作系统」会把这个休眠的进程唤醒,唤醒后的进程就有机会重新获得 CPU 的使用权了。这里的 「进程」 在等待
I/O时之所以会释放CPU使用权,是为了让CPU在这段等待的时间里可以做别的事情,这样一来,CPU的使用率就增加了。如果这时**
另一个进程也在读取文件**,读取文件的操作就会排队,磁盘驱动在完成一个进程的读操作后,发现有排队的任务,就会立即启动下一个读操作,这样I/O 的使用率也增加了。虽然这个逻辑看上去很简单,但是支持 「
进程分时复用」 在操作系统的发展史上有着 「里程碑」 的意义,Unix因为解决了这个问题而名噪天下。「
早期的操作系统」基于「进程」 来调度 CPU,不同的进程之间不共享「内存空间」,所以切换任务就需要切换进程,从而切换「内存映射地址」,而一个进程创建的所有线程,则共享同一个内存空间,所以线程之间的切换成本比进程间切换要低很多。现代的操作系统都是基于更轻量的线程来调度,所以我们现在提到的「任务切换」 指的都是 「线程切换」。Java 并发程序都是基于 多线程的,自然也会涉及到 「任务切换」。而同时任务切换也是
Java并发中 Bug 的源头之一。「任务切换」 的时机大多数是在 时间片结束的时候,我们现在使用的基本都是
高级编程语言,而高级编程语言中的一行代码往往对应着多个CPU 指令操作。比如上面代码中的
count += 1就对应着 3个操作。指令1读取:将count内存加载到 **CPU 寄存器**中指令2修改:将count在寄存器中进行+1操作指令3写入:将寄存器中的结果写入内存。(缓存机机制导致可能写入的是 CPU 缓存而不是 内存)操作系统做任务切换,可以发生在任何一条 「CPU 指令」 执行完成的时候,而不是 高级编程语言中的一条语句。 ↑---【这里对原子性的解释要比 jcip 中更具体一些,我理解的原子性指的是一组高级语句中对应的所有 CPU 指令一起执行完成 才发生切换】对于上面的三条指令来说,假设
count = 0,如果线程A在指令1执行完成后进行了线程切换,线程A 和 线程B 按照下图的顺序执行,那么我们会发现两个线程都执行了count += 1的操作,且count的值都是以0为起点,最终得到的结果是1而不是期望的2。我们将
一个或者多个操作在 CPU 执行的过程中不被中断的特性称为 「原子性」<---【对原子性的定义】。CPU能保证的原子操作需要是CPU指令级别的,而不是高级语言的操作符。这是违背我们直觉的地方,因此很多时候我们需要在**「高级语言层面」**保证操作的
原子性。【所以这一节的内容对于《jcip》 中所讲的 复合操作 带来的线程安全性问题,最终追溯到 Java 中的原子操作是保证线程安全的重要手段】
源头之三:编译优化带来的有序性问题
【也就是**
重排序**问题】并发编程中还有一个容易导致违背直觉性的诡异BUG的原因就是**
有序性**。有序性指的是
程序按照代码的先后顺序执行。 【<--- 对于有序性的定义】但是**
编译器为了优化性能**,有时候会改变程序中语句的先后顺序,例如a=6,b=7编译后可能变成了b=7,a=6这个顺序。 **编译器调整了语句的顺序,但是不影响程序的最终结果。**但是有时候编译器和解释器的优化可能导致意想不到的Bug。Java中的一个经典的关于有序性问题的按理就是利用 「双重检查」 创建单例对象,例如下面的代码:在获取实例
getInstnace()方法中,首先判断intance是否为空,如果为空则锁定Singleton.class并再次检查instance是否为空,如果还未空则创建Singleton的一个实例。假设有两个线程
A、B同时调用getInstance()方法,则同时发现instance == null, 于是同时对Singleton.class加锁,此时JVM保证只有一个线程能够加锁成功(假设是线程A),此时另外一个线程会处于等待状态,线程A 创建一个Singleton实例,然后释放锁,锁被释放后 线程B 被唤醒,线程B 尝试加锁 ,本次加锁可以成功,然后线程B 检查instance == null发现已经有实例被创建,所以线程B 不会再创建一个SIngleton实例。看上去很完美,但是实际上
getInstance()方法存在漏洞, 问题出在new这个操作符上。我们以为的使用
new操作符构造对象的流程:分配一块内存 M初始化Singleton对象赋值给instance变量但是实际上被优化后的执行路径却是这样的:
分配一块内存 MM的地址赋值给instance变量初始化Singleton对象。两者区别就在于,优化后的情况当对象尚未初始化完成的时候就已经被赋值给栈中的引用,此时就已经可以获得该对象了。
这样将会导致:
线程A先执行getInstance()方法,当执行完指令2时发生了线程切换,此时线程B也执行了getInstance()方法,进入判断instance != null是true,所以直接返回了instance,而此时的instance因为**指令重排序的原因,先将堆内存中的地址值赋值给栈中的引用,下面才对堆中对象真正进行初始化,所以此时的instance是一个尚未初始化完成的对象**,如果这个时候直接使用的话,就可能触发 「空指针异常」。【↑所以这里的B 存在的是可见性的问题,此时它看到的是一个未构建成功的 instance 实例】
【这里说明的是「
构造函数」 并不是一个原子操作,未构建完成的对象可能被逸出,导致某些错误的发生,这个是之前我看《Java 并发编程实战》时当时没太理解的一个点,再次看到这个专门看到这个解释我明白了。】下面是对于这个双重检查单例类的流程图解释:
【既然存在这个问题,那么怎么解决呢?】
答案:使用
volatile修饰instance,这样就保证了编译器不会对其进行指令重排序,保证了线程B看到的Instance对象是已经初始化完成的可用对象。总结
想写好
并发程序,首先要知道并发程序的问题可能出现在哪里,是因为什么导致的。只要我们可以深刻的理解
可见性、原子性、有序性在并发场景下的原理,就可以对 Bug 进行比较准确的诊断。这里作者特意提到了缓存导致的可见性问题,线程切换带来的原子性问题,编译优化导致的有序性问题。这些手段的目的都是为了提高性能,但是技术再解决一个问题的同事必然会带来新的问题。
在采用一项技术的同时,一定要清楚它带来的问题是什么,以及如何规避。
专栏和书比起来,知识密度少了许多,所以阅读起来比较轻松, 再加上之前已经使用《jcip》 对并发的基础知识进行了一轮学习,所以对于专栏的学习更多的是加深理解,查漏补缺。 同时更多的实践。